
垃圾收集器有哪些?他们的优势特点是什么?
在什么情况下该选用什么收集器?
3 个回答
 想多了全是问题,想开了全是答案。林动在 JDK 8 中,主要的垃圾收集器有以下几种,每种垃圾收集器都有其独特的优势和适用场景。根据不同应用对**吞吐量**、**暂停时间**、**响应时间**等方面的要求,可以选择合适的垃圾收集器。 ### 1. **Serial GC(串行垃圾收集器)** - **参数**:`-XX:+UseSerialGC` - **特点**: - **单线程收集**:无论是新生代垃圾回收还是老年代的 Full GC,Serial GC 都是使用**单线程**进行垃圾回收。 - **Stop-The-World(STW)暂停时间较长**:垃圾回收过程中,所有应用线程都会暂停,直到垃圾回收完成。 - **适用于小堆内存**:由于 Serial GC 只使用一个线程,因此它在小堆内存的环境中效率尚可,使用多个线程带来的管理开销反而不利于性能。 - **适用场景**: - **单核或低核 CPU 环境**:在资源有限的环境中,串行垃圾收集器可以避免线程管理的开销。 - **内存相对较小的应用**:比如客户端程序或嵌入式系统。 - **不适用场景**: - **高并发、大内存**场景。因为串行垃圾回收导致的长时间停顿在这些场景下是不合理的。 ### 2. **Parallel GC(并行垃圾收集器)** - **参数**:`-XX:+UseParallelGC`(JDK 8 默认收集器) - **特点**: - **多线程并行回收**:在新生代的垃圾回收和 Full GC 时,Parallel GC 会使用多个线程并行执行垃圾回收任务,以缩短垃圾回收的时间。 - **高吞吐量**:Parallel GC 的主要目标是提高**吞吐量**,即最大化应用程序的执行时间,最小化垃圾收集的开销。 - **适用于大堆内存和多核环境**:特别适合 CPU 核数多的服务器环境,可以充分利用多线程并行的优势。 - **适用场景**: - **批处理任务**、后台任务和**吞吐量优先**的应用程序,例如大数据处理、计算密集型任务。 - **对暂停时间要求不高的场景**,例如每天批量运行的应用程序或定期触发的任务。 - **不适用场景**: - **低延迟或响应时间要求高**的应用,因为 Parallel GC 的 Full GC 仍会带来较长的暂停时间。 ### 3. **CMS(Concurrent Mark-Sweep)垃圾收集器** - **参数**:`-XX:+UseConcMarkSweepGC` - **特点**: - **并发回收老年代**:CMS 收集器的特点是它与应用线程并发执行标记和清除老年代的垃圾,这样就减少了 Full GC 过程中应用暂停的时间。 - **低停顿时间**:CMS 的主要目标是减少老年代的垃圾回收引发的长时间停顿,因此适用于对响应时间要求较高的应用。 - **碎片化问题**:CMS 采用**标记-清除算法**,容易造成老年代内存碎片化,如果碎片过多,可能引发 Full GC 并导致长时间暂停。 - **适合中等堆大小**:CMS 在大堆内存下效率有所下降,内存碎片会显著增加 Full GC 的频率。 - **适用场景**: - **响应时间优先**的应用,如互联网服务、Web 服务器等需要快速响应请求的场景。 - **对低延迟有要求**的应用,例如在线支付、社交平台、Web 应用等。 - **不适用场景**: - **内存碎片敏感的应用**,CMS 的碎片化问题可能会引发频繁的 Full GC。 - **大堆内存环境**,CMS 在大堆内存下性能表现不佳。 ### 4. **G1(Garbage First)垃圾收集器** - **参数**:`-XX:+UseG1GC` - **特点**: - **区域化内存管理**:G1 将堆划分为多个独立的小区域(Region),每个区域可以是新生代或老年代的一部分。G1 使用这些区域化管理内存,便于更加灵活地回收垃圾。 - **并发回收**:G1 通过并发标记和整理,减少垃圾回收的暂停时间。 - **可预测的暂停时间**:G1 允许用户通过 `-XX:MaxGCPauseMillis` 设置期望的最大垃圾回收暂停时间,G1 会根据此目标动态调整回收行为。 - **标记-整理算法**:G1 使用标记-整理算法来避免内存碎片问题,特别适合大堆内存场景。 - **适用场景**: - **大内存**(数 GB 到数十 GB 甚至更多)的应用场景,特别适合大型服务器应用。 - **响应时间要求**严格、希望能控制垃圾回收的应用,例如金融服务、在线交易平台等。 - **内存管理复杂的应用**,特别是在堆内存比较大、对象存活率较高时,G1 能更好地避免内存碎片化。 - **不适用场景**: - G1 的 Full GC 效率不如 Parallel GC,但相较于 CMS,G1 已经优化了 Full GC 频率,因此没有显著的“禁用”场景。 ### 5. **Serial Old GC 和 Parallel Old GC** - **Serial Old GC**:作为 Serial GC 的老年代版本,采用单线程执行老年代垃圾回收。 - **适用场景**:用于客户端模式,单核 CPU 或低资源环境。 - **Parallel Old GC**:与 Parallel GC 配合,负责老年代的垃圾回收,同样采用并行线程执行。 - **适用场景**:吞吐量优先的后台任务和多核 CPU 环境,常与 Parallel GC 结合使用。 ### 垃圾收集器选择建议(基于 JDK 8) - **小型应用,内存压力不大,单线程系统**: - **选择 Serial GC**:`-XX:+UseSerialGC` - 适用于桌面应用、小型服务、嵌入式系统等场景。 - **大规模批处理任务、吞吐量优先**: - **选择 Parallel GC**:`-XX:+UseParallelGC` - 适合高吞吐量的应用,比如大数据处理、批处理系统、后台任务。 - **响应时间优先,延迟敏感的应用**: - **选择 CMS**:`-XX:+UseConcMarkSweepGC` - 适用于互联网应用、Web 服务等需要低延迟的场景。 - **大堆内存、高响应要求的应用**: - **选择 G1 GC**:`-XX:+UseG1GC` - 适合大堆内存、要求可预测的暂停时间的系统,如在线交易、支付系统、大型服务器应用。 ### 总结 选择垃圾收集器时,需要根据应用的特定需求(例如吞吐量、暂停时间、延迟敏感度等)来确定。对于 **小型内存应用**,可以选择 **Serial GC**;如果是 **吞吐量优先**的批处理或后台任务,**Parallel GC** 是理想选择;对于 **低延迟和响应时间要求高的应用**,CMS 或 **G1** 会是更好的选择。在 **大堆内存的情况下**,G1 是 JDK 8 中推荐的选择,它提供了平衡吞吐量和暂停时间的能力。发布于 2023-09-26 13:56 •IP属地 吉林举报评论收藏
 遇见错的人会消耗你,遇见对的人会治愈你。java小王子一般老年代使用的就是标记-整理,或者标记-清除+标记-整理结合(例如CMS) 新生代就是标记-复制算法 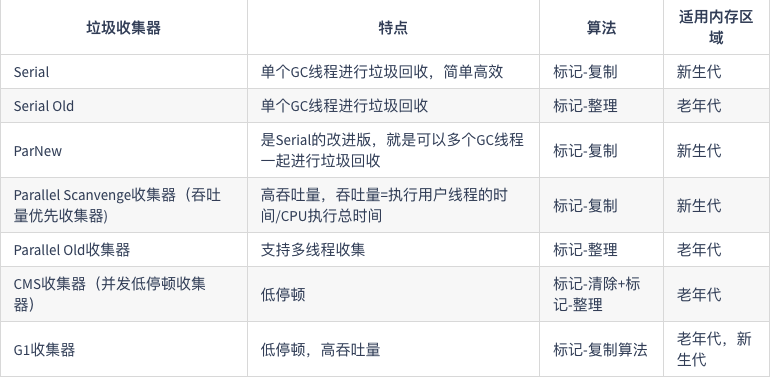 ### Serial收集器(标记-复制算法) 就是最简单的垃圾收集器,也是目前 JVM 在 Client 模式默认的垃圾收集器,在进行垃圾收集时会停止用户线程,然后使用一个收集线程进行垃圾收集。主要用于新生代,使用标记-复制算法。 优点是简单高效(与其他收集器的单线程比),内存占用小,因为垃圾回收时就暂停所有用户线程,然后使用一个单线程进行垃圾回收,不用进行线程切换。 缺点是收集时必须停止其他用户线程。 ### Serial Old收集器(标记-整理算法) 跟Serial收集器一样,不过是应用于老年代,使用标记-整理算法。 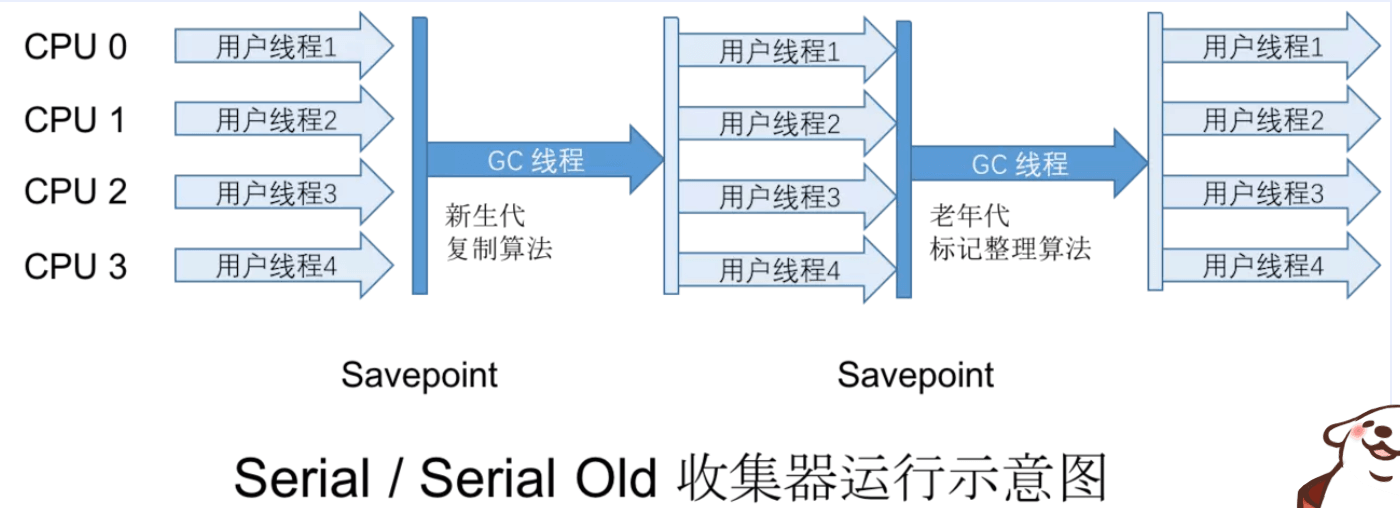 ### ParNew收集器(标记-复制算法) ParNew收集器是Serial收集器的多线程并行版本,在进行垃圾收集时可以使用多个线程进行垃圾收集。 与Serial收集器主要区别就是支持多线程收集,ParNew收集器应用广泛(JDK9以前,服务端模式垃圾收集组合官方推荐的是ParNew+CMS),因为只有Serial和ParNew才能配合CMS收集器(应用于老年代的并发收集器)一起工作。 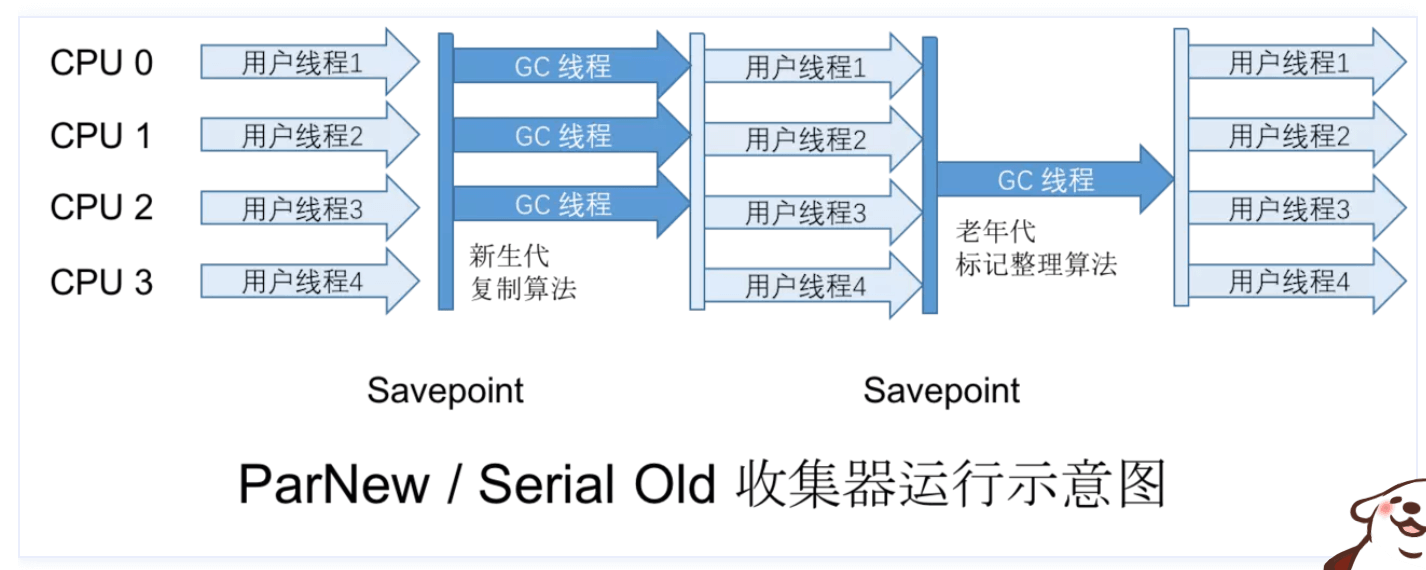 ### Parallel Scanvenge收集器(吞吐量优先收集器) 也支持多线程收集,它的目标是达到一个可控制的吞吐量,就是运行用户代码的时间/(运行用户代码的时间+垃圾回收的时间)比值。高吞吐量可以最高效率地利用处理器资源,尽快完成程序运算任务,适合不需要太多的交互分析任务。不支持并发收集,进行垃圾回收时会暂停用户线程,使用多个垃圾回收线程进行垃圾回收。 ### Parallel Old收集器 是Parallel Scanvenge老年代版本,支持多线程收集,使用标记整理法实现的。 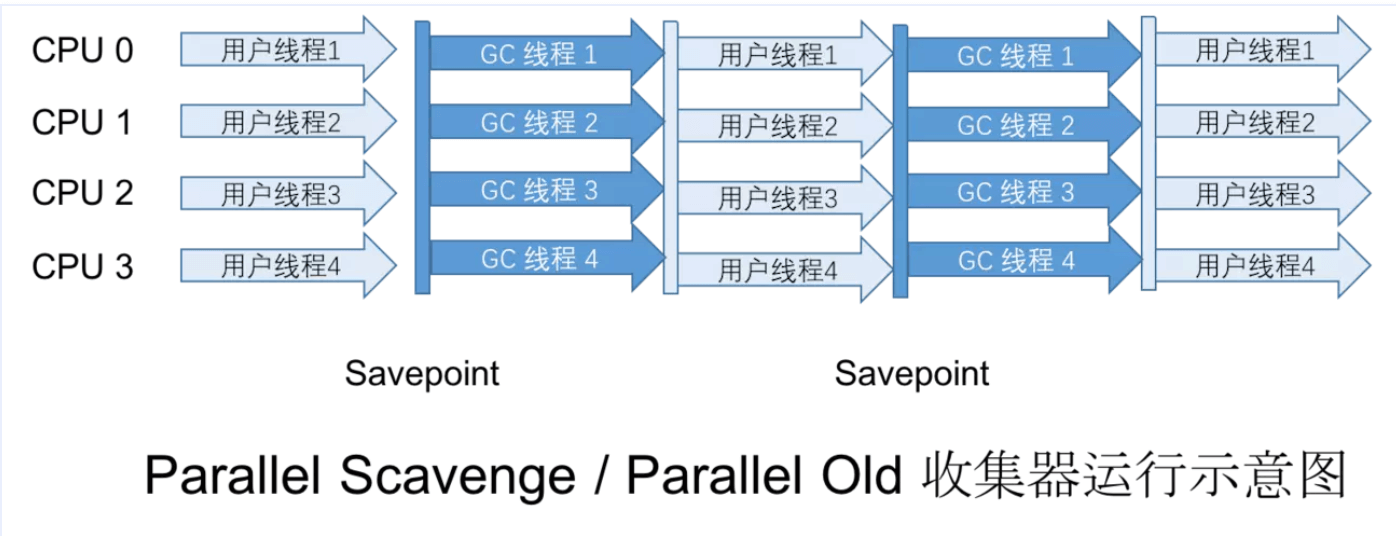 ### CMS 收集器(老年代并发低停顿收集器) CMS收集器是第一个支持并发收集的垃圾收集器,在垃圾收集时,用户线程可以和收集线程一起工作,它的执行目标是达到最短回收停顿时间,以获得更好的用户体验。 CMS英文是Concurrent Mark Sweep,是基于标记-清除法+标记-整理算法实现的,步骤如下: 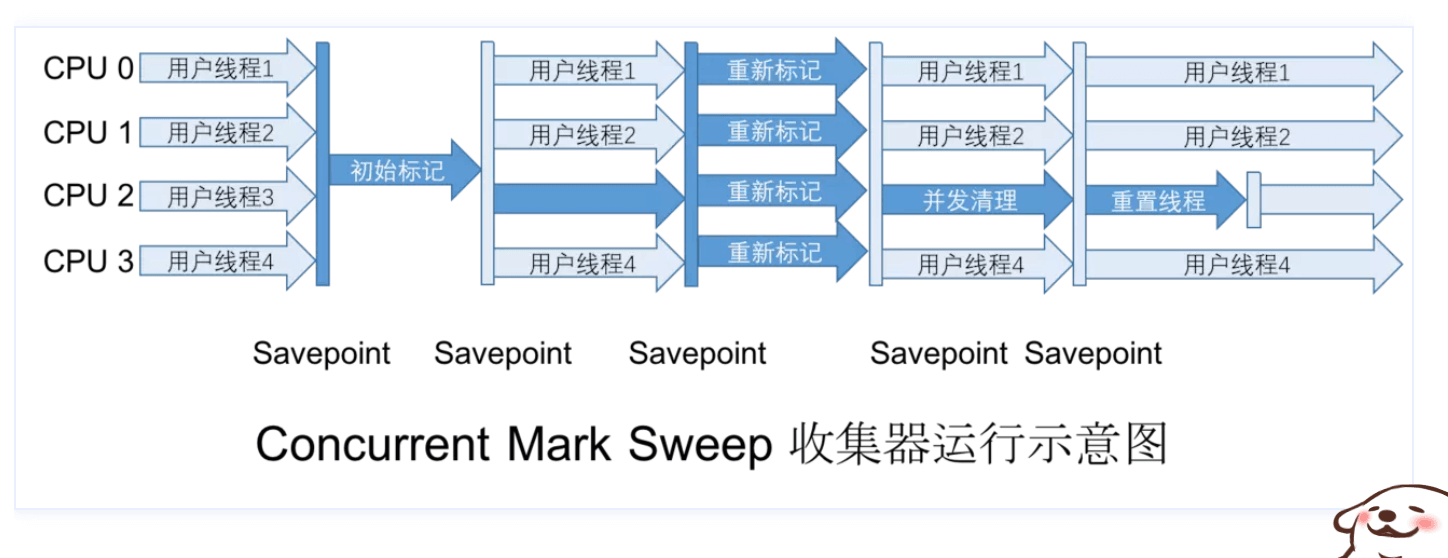 #### 1.初始标记 标记那些GC Roots可以直接关联到的对象。 #### 2.并发标记(可以与用户线程并发执行) 从GC Roots能关联到的对象直接向下遍历整个对象图,耗时较长,但是可以与用户线程并发执行。 整个标记过程是采用三色标记法来实现的: 白色:代表还没有遍历的对象。 灰色:代表已遍历到的对象,但是它直接引用的对象还没有遍历完。 黑色:代表已遍历到的对象,它直接引用的对象也都已经遍历完。 #### 执行流程: 1.先将所有对象放到白色集合,然后将GC Roots能关联的对象添加到灰色集合。 2.对灰色集合中对象进行遍历,假设从灰色集合中取出的对象是A,将对象A引用的所有对象添加到灰色集合,全部添加完毕后,将A添加到黑色集合。 3.重复第2步,直到灰色集合为空。 #### 三色标记法的一些问题: 1.对于多标的情况,会生成浮动垃圾 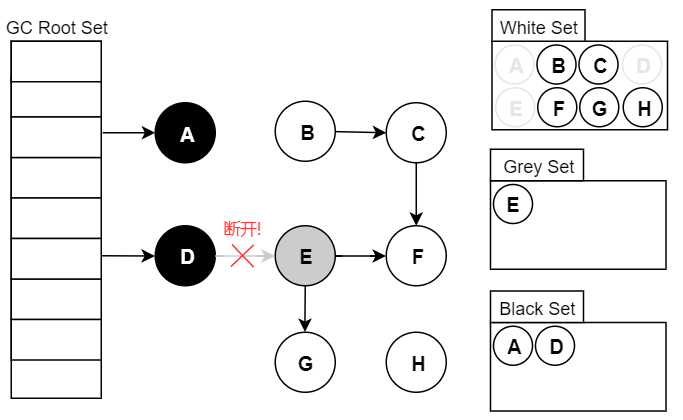 标的情况,对象E/F/G是“应该”被回收的。然而因为E已经变为灰色了,其仍会被当作存活对象继续遍历下去。最终的结果是:这部分对象仍会被标记为存活,即本轮GC不会回收这部分内存。 这部分本应该回收 但是 没有回收到的内存,被称之为“浮动垃圾”。浮动垃圾并不会影响垃圾回收的正确性,只是需要等到下一轮垃圾回收中才被清除。 另外,针对并发标记开始后的新对象,通常的做法是直接全部当成黑色,本轮不会进行清除。这部分对象期间可能会变为垃圾,这也算是浮动垃圾的一部分。 #### 2.对于引用变动后导致漏标情况的处理 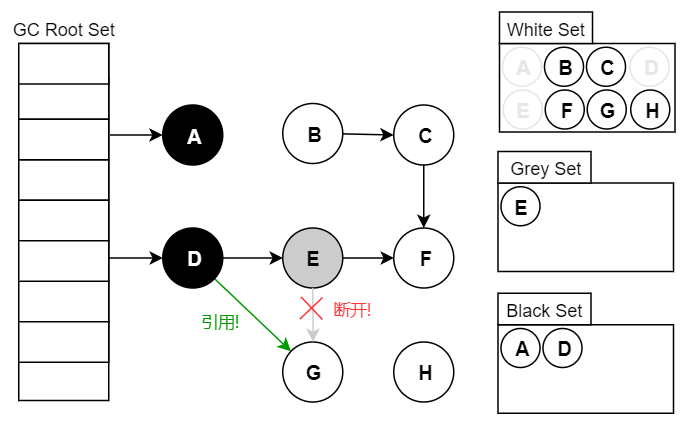 #### 增量更新法 对于这种漏标的情况,CMS垃圾收集器使用的是增量更新法,就是将引用变化后的引用情况进行记录,然后之后进行标记。也就是当E->G变成了E->null,D->G,会对更改后的引用D->G进行记录,用于在重新标记阶段对这种情况进行处理。 #### 原始快照法 就是对于这种E->G,然后改成D->G,正常来说,应该可能会漏掉,因为D已经是黑色对象了,就不会遍历G了,G1垃圾收集器对这种情况的处理是保存原始快照,就是在并发标记过程中,引用的变动,都会对变动前的引用情况进行记录,会按照变动前的引用情况进行标记,也就是即便E->G变成了E->null,D->G变化了,还是会记录E->G的引用情况,用于在重新标记阶段对这种情况进行处理。 #### 3.重新标记 由于标记时,用户线程在运行,并发标记阶段存在一些标记变动的情况,这一阶段就是修正这些记录。(CMS采用增量更新算法来解决,主要是将更改后的引用关系记录,之后增量更新) #### 4.并发清除 清除标记阶段判断的已经死亡的对象,由于不需要移动存活对象,这个阶段也可以与用户线程并发执行。 ### G1收集器(Garbage First收集器,标记-整理算法,老年代,新生代都进行回收) 目标是在延迟可控(用户设定的延迟时间)的情况下获得尽可能高的吞吐量。 JDK9以前,服务端模式默认的收集器是Parallel Scavenge+Serial Old。JDK9及之后,默认收集器是G1。G1不按照新生代,老年代进行划分,而是将Java堆划分为多个大小相等的独立Region,每一个Region可以根据需要,扮演新生代的Eden空间,Survivor空间,老年代Old空间和用于分配大对象的Humongous区。回收思路是G1持续跟踪各个Region的回收价值(回收可释放的空间和回收所需时间),然后维护一个优先级列表,在用户设定的最大收集停顿时间内,优先回收那些价值大的Region。 JDK 8 和9中,Region的大小是通过(最大堆大小+最小堆大小)的平均值/2048,一般是需要在1到32M之间。G1认为2048是比较理想的Region数量 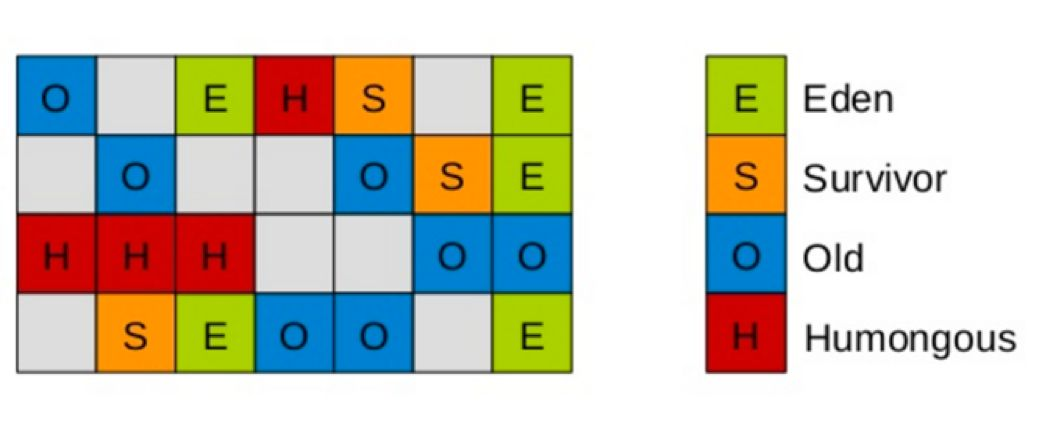 #### G1对象分配策略 说起对象的分配,我们不得不谈谈对象的分配策略。它分为4个阶段: 1. 栈上分配 2. TLAB(Thread Local Allocation Buffer)线程本地分配缓冲区 3. 共享Eden区中分配 4. Humongous区分配(超过Region大小50%的对象) 对象在分配之前会做逃逸分析,如果该对象只会被本线程使用,那么就将该对象在栈上分配。这样对象可以在函数调用后销毁,减轻堆的压力,避免不必要的gc。 如果对象在栈是上分配不成功,就会使用TLAB来分配。TLAB为线程本地分配缓冲区,它的目的为了使对象尽可能快的分配出来。如果对象在一个共享的空间中分配,我们需要采用一些同步机制来管理这些空间内的空闲空间指针。在Eden空间中,每一个线程都有一个固定的分区用于分配对象,即一个TLAB。分配对象时,线程之间不再需要进行任何的同步。 对TLAB空间中无法分配的对象,JVM会尝试在共享Eden空间中进行分配。如果是大对象,则直接在Humongous区分配。 最后,G1提供了两种GC模式,Young GC和Mixed GC,两种都是Stop The World(STW)的。下面我们将分别介绍一下这2种模式。 #### G1 Young GC Young GC主要是对Eden区进行GC,它在Eden空间耗尽时会被触发。在这种情况下,Eden空间的数据移动到Survivor空间中,如果Survivor空间不够,Eden空间的部分数据会直接晋升到年老代空间。Survivor区的数据移动到新的Survivor区中,也有部分数据晋升到老年代空间中。最终Eden空间的数据为空,GC停止工作,应用线程继续执行。 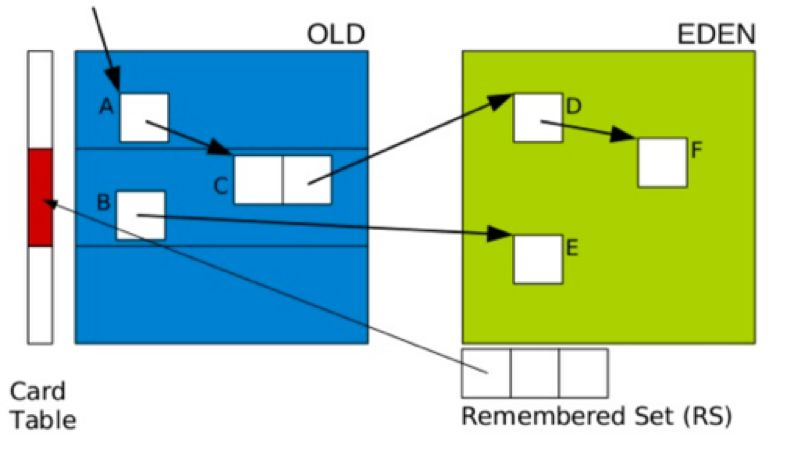 #### Region如何解决跨代指针? 因为老年代old区也会存在对新生代Eden区的引用,如果只是为了收集Eden区而对整个老年代进行扫描,那样开销太大了,所以G1其实会将每个Region分为很多个区,每个区有一个下标,当这个区有对象被其他Region引用时,那么CardTable对应下标下值为0,然后使用一个Rset来存储老年代Region对当前这个新生代Region的引用,Key是别的Region的起始地址,Value是一个集合,里面的元素是Card Table的Index。对跨代引用的扫描,只需要扫描RSet就行了。 在CMS中,也有RSet的概念,在老年代中有一块区域用来记录指向新生代的引用。这是一种point-out,在进行Young GC时,扫描根时,仅仅需要扫描这一块区域,而不需要扫描整个老年代。 但在G1中,并没有使用point-out(就是记录当前Region对其他Region中对象的引用),这是由于一个Region太小,Region数量太多,如果是用point-out的话,如果需要计算一个Region的可回收的对象数量,需要把所有Region都是扫描一遍会造成大量的扫描浪费,有些根本不需要GC的分区引用也扫描了。于是G1中使用point-in来解决。point-in的意思是哪些Region引用了当前Region中的对象。这样只需要将当前Region中这些对象当做初始标记时的根对象来扫描就可以扫描出因为有跨代引用需要存活的对象,避免了无效的扫描。 #### 由于新生代有多个,那么我们需要在新生代之间记录引用吗? 这是不必要的,原因在于每次GC时,所有新生代都会被扫描,所以只需要记录老年代的Region对新生代的这个Region之间的引用即可。 需要注意的是,如果引用的对象很多,赋值器需要对每个引用做处理,赋值器开销会很大,为了解决赋值器开销这个问题,在G1 中又引入了另外一个概念,卡表(Card Table)。一个Card Table将一个分区在逻辑上划分为固定大小的连续区域,每个区域称之为卡。卡通常较小,介于128到512字节之间。CardTable通常为字节数组,由Card的索引(即数组下标)来标识每个分区的空间地址。默认情况下,每个卡都未引用。当一个地址空间有引用时,这个地址空间对应的数组索引的值被标记为"0",即标记为脏引用,此外RSet也将这个数组下标记录下来。一般情况下,这个RSet其实是一个Hash Table集合(每个线程对应一个Hash Table,主要是为了减少多线程并发更新RSet的竞争),每个哈希表的Key是别的Region的起始地址,Value是一个集合,里面的元素是Card Table的Index。 如果Rset是记录每个外来Region对当前Region中对象的引用,这样数量就太多了,所以Card Table只是有很多Byte字节,每个字节记录了Region对应的一个内存区域(卡页)是否是dirty的,为1代表dirty,也就是有其他Region对这个卡页中的对象进行引用。 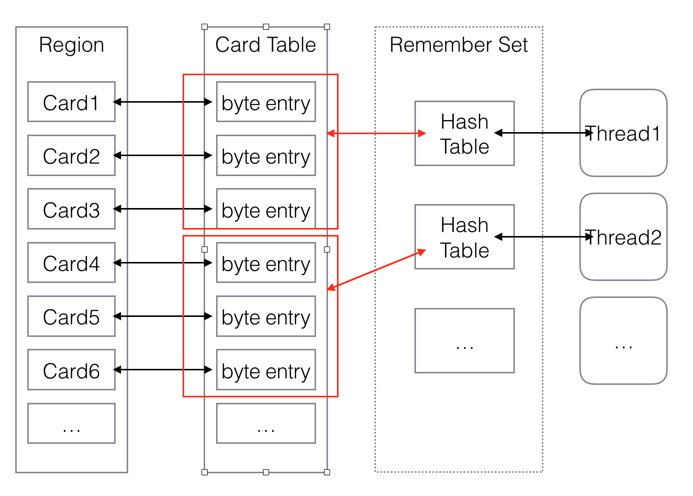 #### G1 MixGC MixGC不仅进行正常的新生代垃圾收集,同时也回收部分后台扫描线程标记的老年代分区。Young GC回收是把新生代活着的对象都拷贝到Survivor的特定区域(Survivor to),剩下的Eden和Survivor from就可以全部回收清理了。那么,mixed GC就是把一部分老年区的region加到Eden和Survivor from的后面,合起来称为collection set, 就是将被回收的集合,下次mixed GC evacuation把他们所有都一并清理。选old region的顺序是垃圾多的(存活对象少)优先。 它的GC步骤分2步: 1. 全局并发标记(global concurrent marking) 2. 拷贝存活对象(evacuation) 在进行Mix GC之前,会先进行global concurrent marking(全局并发标记)。 global concurrent marking的执行过程是怎样的呢? 在G1 GC中,它主要是为Mixed GC提供标记服务的,并不是一次GC过程的一个必须环节。global concurrent marking的执行过程分为五个步骤: 1. 初始标记(initial mark,STW) 在此阶段,G1 GC 对根进行标记。该阶段与常规的(STW) 新生代垃圾回收密切相关。 2. 根区域扫描(root region scan) ``` G1 GC 在初始标记的存活区扫描对老年代的引用,并标记被引用的对象。该阶段与应用程序(非 STW)同时运行,并且只有完成该阶段后,才能开始下一次 STW 新生代垃圾回收。 ``` 3. 并发标记(Concurrent Marking) ``` G1 GC 在整个堆中查找可访问的(存活的)对象。该阶段与应用程序同时运行,可以被 STW 新生代垃圾回收中断 ``` 4. 最终标记(Remark,STW) ``` 该阶段是 STW 回收,帮助完成标记周期。G1 GC清空 SATB 缓冲区,跟踪未被访问的存活对象,并执行引用处理。 ``` 4. 清除垃圾(Cleanup,STW) ``` 在这个最后阶段,G1 GC 执行统计和 RSet 净化的 STW 操作。在统计期间,G1 GC 会识别完全空闲的区域和可供进行混合垃圾回收的区域。清理阶段在将空白区域重置并返回到空闲列表时为部分并发。 ``` ### 收集步骤: 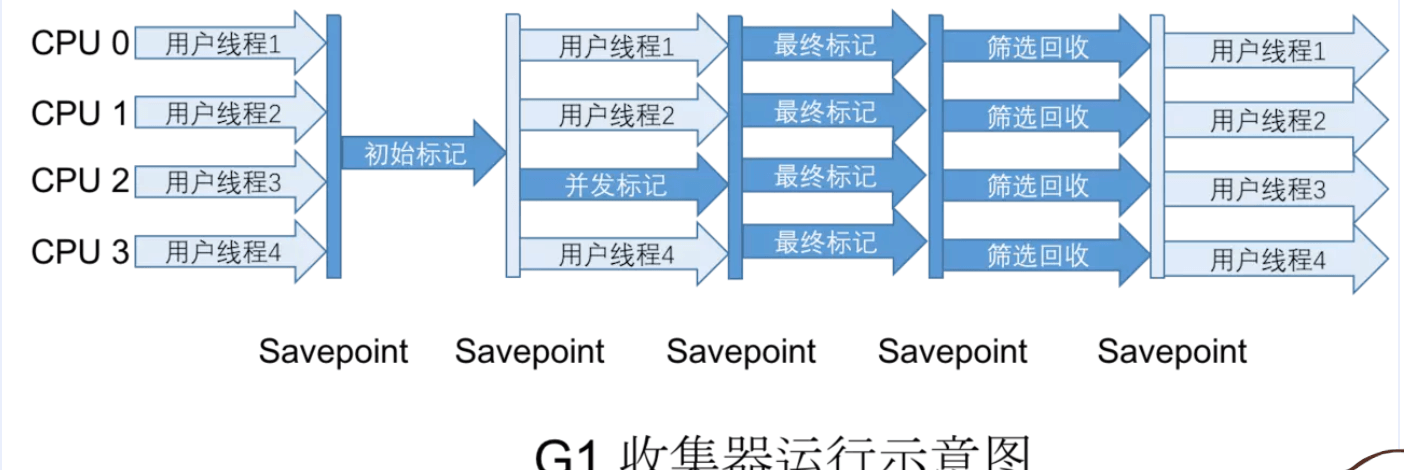 **初始标记** 只标记GC Roots直接引用的对象 **并发标记** 从GC Roots开始对堆中对象进行可达性分析,扫描整个对象图,找出要回收的对象。(可以与用户线程并发执行) **最终标记** 对并发标记阶段,由于用户线程执行造成的改动进行修正,使用原始快照方法。 筛选回收 对Region进行排序,根据回收价值,选择任意多个Region构成回收集,将存活对象复制到空的Region中去,因为涉及到存活对象的移动,所以是暂停用户线程的。 相关资料: [https://www.jianshu.com/p/aef0f4765098](https://www.jianshu.com/p/aef0f4765098)发布于 2022-02-19 06:00 •IP属地 青海举报评论收藏
 在漆黑的夜里,你需要一道光照亮夜行的路,我燃烧了我自己,但也造就了你我不能相拥。蚂蚱Parallel Scanvenge收集器(吞吐量优先收集器) 吞吐量优先。 CMS 收集器(老年代并发低停顿收集器) G1收集器(Garbage First收集器,标记-整理算法,老年代,新生代都进行回收)一般用于大内存的,因为他对cpu,和内存是有一个消耗的,15~30%.对要回收的对象有优先级的设置。有消耗。发布于 2022-02-15 11:29 •IP属地 安徽举报评论收藏
公众号进入网站体验更佳
