
mysql如何解决深度分页的问题?
1 个回答
 在漆黑的夜里,你需要一道光照亮夜行的路,我燃烧了我自己,但也造就了你我不能相拥。蚂蚱这里我们测试两条sql来展示一下mysql的深度分页问题 从偏移量为100的地方取3条 ``` select * from wjdcxx w where w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate limit 100,3; ``` 从偏移量为100W的地方取3条 ``` select * from wjdcxx w where w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate limit 1000000,3; ``` 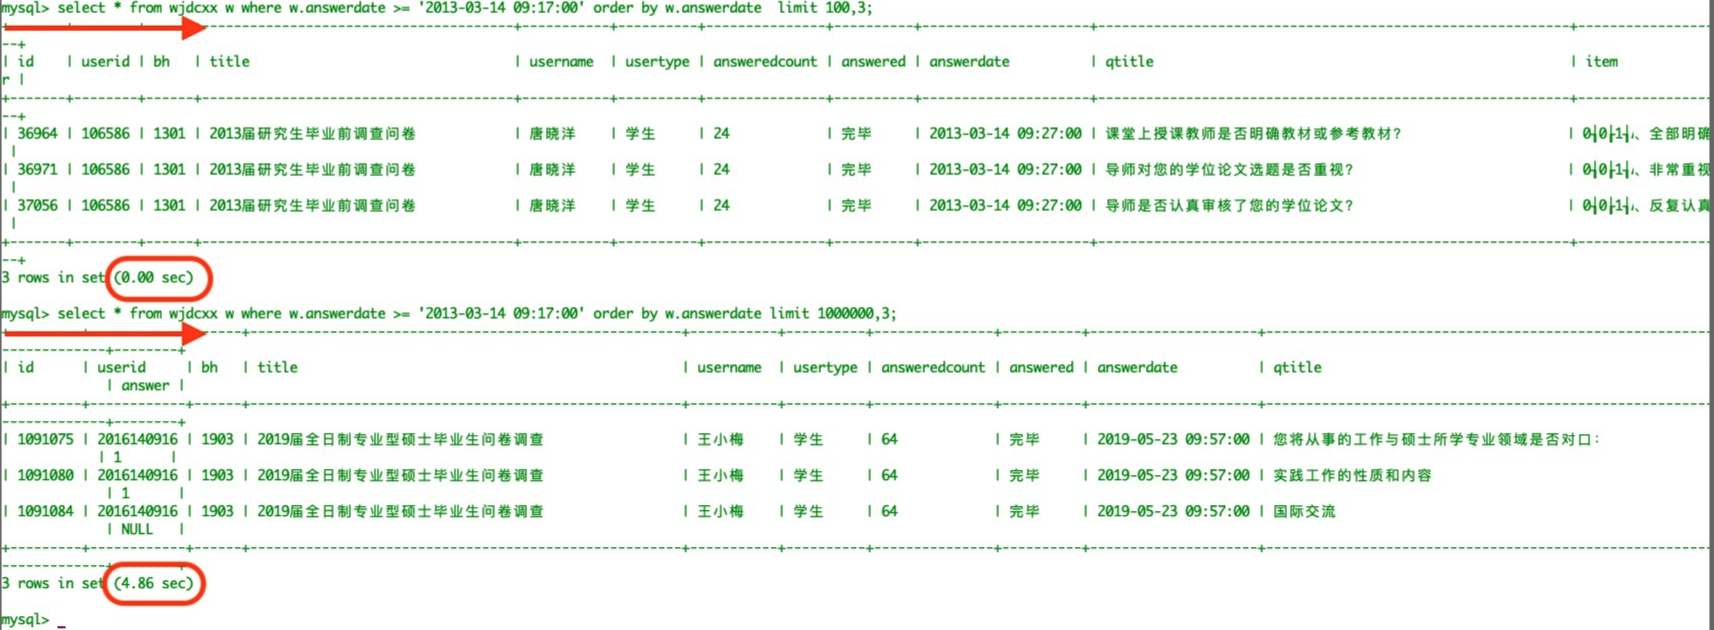 可以看到第一条sql的结果几乎是秒出,第二条sql用了将近5秒,仅仅是一个偏移量的差别,这个时间在业务中我们是没办法忍受的,事实上随着偏移量的增大这个时间还会呈几何式增长 网上有这张图片可以说明 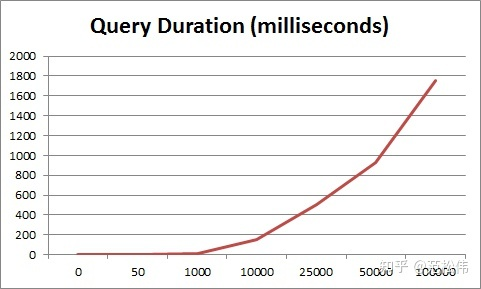 在做查询的时候经常做分页,然后随着数据库数据量增大,页数增多(即偏移量的增加),查询速度页成指数下降 如何解决问题: 我们先来分析下这两条语句 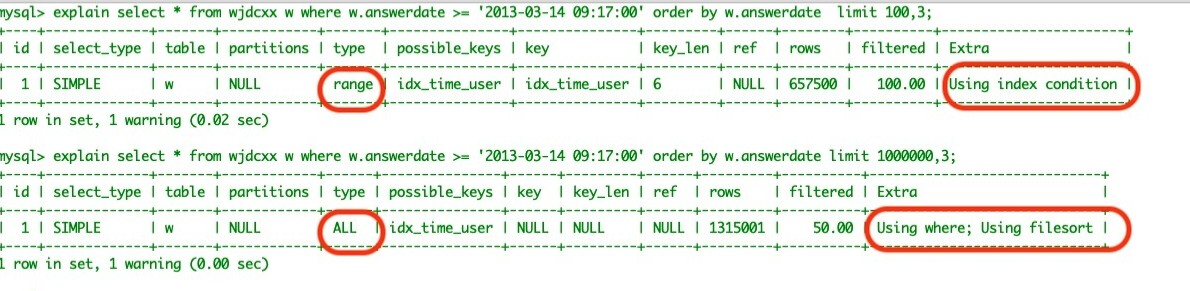 在此先介绍一下执行计划Extra列可能出现的值及含义: 1. Using where:表示优化器需要通过索引回表查询数据。 2. Using index:即覆盖索引,表示直接访问索引就足够获取到所需要的数据,不需要通过索引回表,通常是通过将待查询字段建立联合索引实现。 3. Using index condition:在5.6版本后加入的新特性,即大名鼎鼎的索引下推,是MySQL关于减少回表次数的重大优化。 4. Using filesort:文件排序,这个一般在ORDER BY时候,数据量过大,MySQL会将所有数据召回内存中排序,比较消耗资源。 再看看上图,同样的语句,只因为偏移量不同,就造成了执行计划的千差万别。第一条语句LIMIT 100,3 type列的值是range,表示范围扫描,性能比ref差一个级别,但是也算走了索引,并且还应用了索引下推:就是说在WHERE之后的回答时间走了索引,并且之后的ORDER BY也是根据索引下推优化,在执行WHERE条件筛选时同步进行的(没有回表)。 而第二条语句LIMIT 1000000,3压根就没走索引,type列的值是ALL,显然是全表扫描。并且Extra列字段里的Using where表示发生了回表,Using filesort表示ORDER BY时发生了文件排序。所以这里慢在了两点:一是文件排序耗时过大,二是根据条件筛选了相关的数据之后,需要根据偏移量回表获取全部值。无论是上面的哪一点,都是LIMIT偏移量过大导致的,所以实际开发环境经常遇到非统计表量级不得超过一百万的要求。 我们可以通过几种方案来解决这个问题: 第一种方法:通过主键索引优化。在查询下一页时把上一页的最大Id带过来,然后sql就改成了 ``` select * from wjdcxx w where w.id > #{maxId} and w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate desc limit 3; ``` 如上代码所示,同样也是分页,但是有个maxId的限制条件,这个是什么意思呢,maxId就是上一页中的最大主键Id。 如下图一页页翻就可以了。一次性查6条,和分页后每次查3条组合起来的是摸一样的 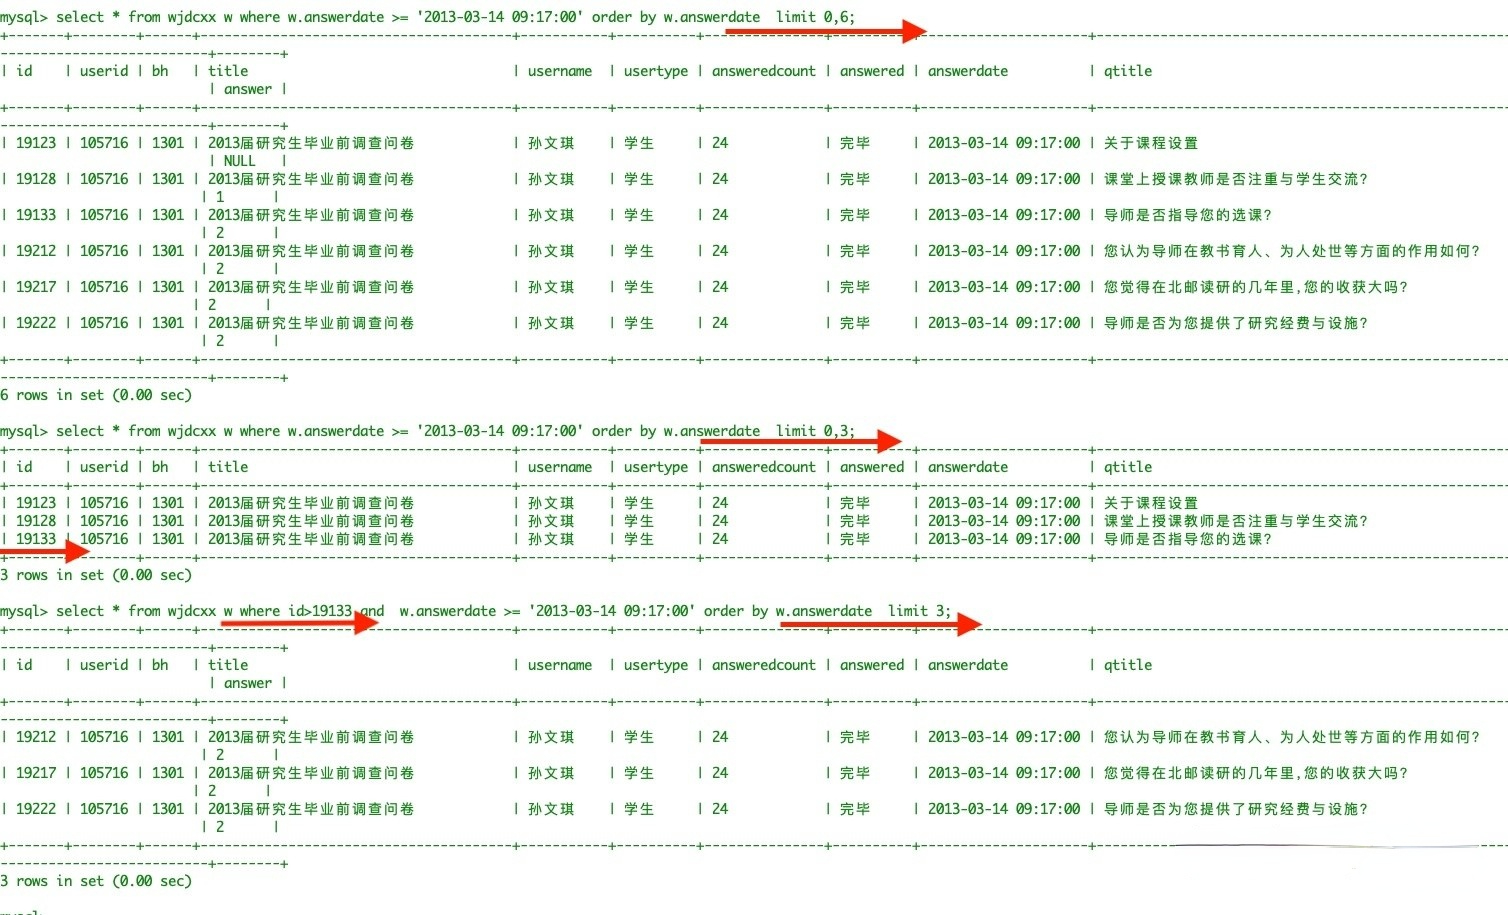 不要怀疑到最好的速度我们可以试验下 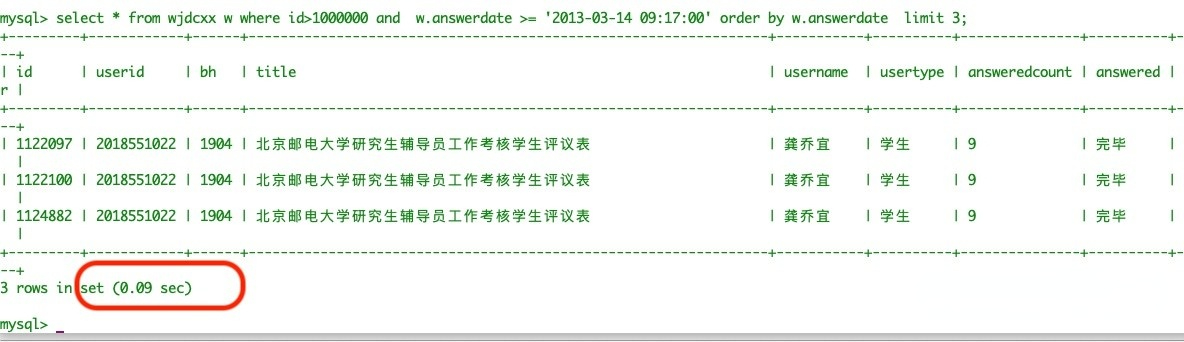 所以采用此方式的前提: 1)主键必须自增不能是UUID并且前端除了传基本分页参数pageNo,pageSize外,还必须把每次上一页的最大Id带过来, 2)该方式不支持随机跳页,也就是说只能上下翻页。 ### 第二种方法:延迟关联 我们来分析一下 ``` select * from wjdcxx w where w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate limit 1000000,3; ``` 和 ``` select id from wjdcxx w where w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate limit 1000000,3; ``` 仅仅是select后面的字段不同,我们来看看查询时间 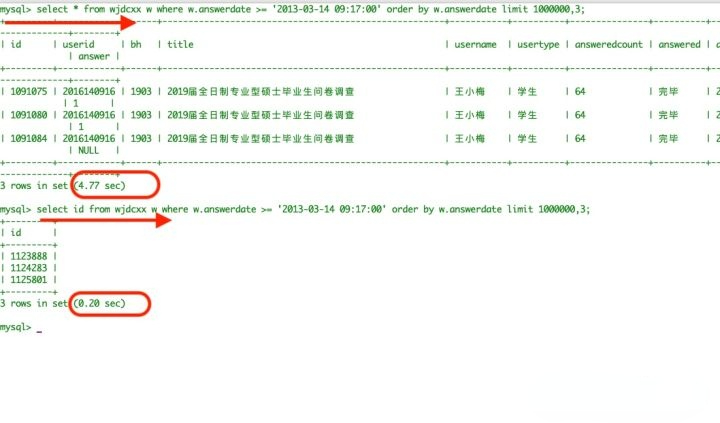 时间相差那不是一个数量级啊。 通过这条语句我们得到了一页的记录id,我们可以通过连表的方法得到记录的详细信息,我们看看这个连表语句的查询情况 ``` select * from wjdcxx inner join (select id from wjdcxx w where w.answerdate >= '2013-03-14 09:17:00' order by w.answerdate limit 1000000,3) as tmp on tmp.id= wjdcxx.id; ``` 这种查询模式,其原理依赖于覆盖索引,当查询的列,均是索引字段时,性能较快,因为其只用遍历索引本身。 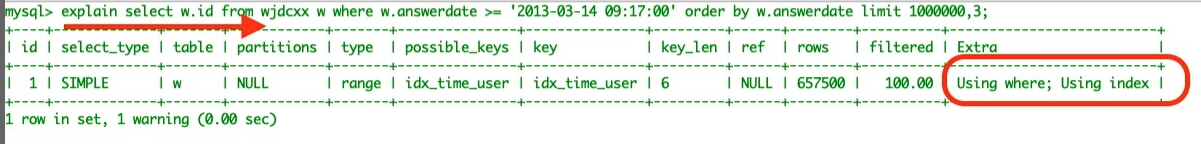 果然如此覆盖索引。 ### 第三种方法: 通过Elastic Search搜索引擎(基于倒排索引),实际上类似于淘宝这样的电商基本上都是把所有商品放进ES搜索引擎里的(那么海量的数据,放进MySQL是不可能的,放进Redis也不现实)。但即使用了ES搜索引擎,也还是有可能发生深度分页的问题的,这时怎么办呢?答案是通过游标scroll。另一个是search_after。关于此点这里不做深入,感兴趣的可以做研究。 (1)es默认使用的也是from,size的查询方式,和mysql类似。比如我们要找from=200,size=10。那么es需要在每个分片上,根据条件查找210条数据,然后进行排序处理,最后在所有的结果中取10条返回,这种查询浪费很多机器资源.并且es设置了分页的深度max_result_window,7.x之前默认是1w,7.x之后默认是25000。如果from+size超过了这个长度,分页查询就会抛异常。如果一定要用这种方式去分页查询,就要修改对应的设置。 (2)es提供了2种其他的分页查询的方式,一个是scroll,另一个是search_after。 其中scroll 相当于对查询维护了一份快照,初始化时将所有符合搜索条件的搜索结果缓存起来,遍历的时候从这份快照里取数据。因此不适合作为实时数据的查找,。在每次使用scroll的时候,需要制定一个时间窗口,每次搜索在时间窗口内完成即可。第一次请求后会返回一个scorll id,之后的请求要带着这个scrollid参数去查询。 (3)search_after是5.x版本之后提供的另一种分页查询方式。根据上一页来确定下一页的位置,这就跟我们上述mysql 的处理方式很像。并且如果索引数据有修改,也会实时查询出来,反映到对应的游标中。适合用于实时分页查找,但是不满足跳页查找,只能用于上一页下一页的这种查找。编辑于 2022-02-19 00:17 •IP属地 安徽举报评论收藏2
公众号进入网站体验更佳
