
什么是堆什么是栈?
6 个回答
 纵然前路迷茫,纵然天隔一方,纵然我手中的刀刃已然破碎,也无法阻挡我寻找你的道路。凤舞### 堆和栈的区别 #### 功能不同 - **栈内存**:用于存储局部变量和方法调用的运行时数据,包括基本数据类型和对象引用。栈内存代表着逻辑的执行顺序。 - **堆内存**:用于存储 Java 中的对象实例。无论是成员变量、局部变量还是类变量,它们指向的对象都存储在堆内存中。堆内存代表着数据的存储。 #### 共享性不同 - **栈内存**:线程私有,每个线程都有自己的栈内存,互不干扰。 - **堆内存**:所有线程共享。多个线程可以访问堆中的同一个对象。 #### 异常错误不同 - **栈内存不足**:会抛出 `java.lang.StackOverflowError`。这通常是由于递归过深或方法调用过多导致的。 - **堆内存不足**:会抛出 `java.lang.OutOfMemoryError`。这通常是由于创建过多对象或内存泄漏导致的。 #### 空间大小 - **栈内存**:空间较小,通常由操作系统自动分配和释放,空间连续,没有碎片。 - **堆内存**:空间较大,由 JVM 管理,可以动态分配和回收,区域不连续,可能会有碎片。 #### 其他区别 - **栈是运行时单位**:代表逻辑的执行顺序,内含基本数据类型和堆中对象的引用,所在区域连续,没有碎片。 - **堆是存储单位**:代表数据的存储,可被多个栈共享,包括成员变量中的基本数据类型、引用和引用对象,所在区域不连续,会有碎片。 通过这几个方面的比较,可以更清晰地理解堆和栈的区别及其各自的作用。发布于 2024-05-09 07:02 •IP属地 贵州举报评论收藏
 不要在赚钱的路上把健康丢了,要在健康的路上顺便把钱赚了。美啦美啦美啦### 什么是堆和栈? 堆和栈是两种不同的内存分配方式,用于从操作系统中获取内存。它们各自有不同的用途和特性。 #### 栈 栈是与特定的CPU寄存器(如stack pointer, SP)紧密相关的内存区域。它通常用于存储函数调用时的局部变量、函数参数和返回地址。栈具有以下特点: 1. **自动管理**:当函数被调用时,局部变量和参数自动压入栈中,函数返回时,自动弹出。 2. **快速访问**:由于栈是LIFO(后进先出)的结构,存取速度非常快。 3. **空间有限**:栈的空间有限,如果递归调用过深或局部变量过多,可能会导致栈溢出。 **栈的工作原理**: - 函数调用时,CPU使用特定指令将当前指令指针(IP)压入栈中,并将被调用函数的地址赋给IP。 - 进入函数时,SP向下扩展,分配足够的空间存储局部变量。 - 函数返回时,SP恢复到调用前的位置,释放局部变量的空间。 #### 堆 堆是用于动态内存分配的区域。程序在运行时可以使用`malloc`、`new`等函数从堆中申请内存,并在不需要时使用`free`或`delete`释放内存。堆具有以下特点: 1. **动态管理**:程序可以在运行时灵活地申请和释放内存。 2. **较慢访问**:由于需要管理已用和空闲内存块的链表,内存分配和释放的速度较慢。 3. **容易碎片化**:频繁的内存分配和释放会导致内存碎片,使得可用的内存块无法满足大块内存的申请。 **堆的工作原理**: - 堆中维护一个链表来管理已用和空闲的内存块。 - 当程序申请内存时,堆从空闲的内存块中找到合适的块进行分配,并更新链表。 - 如果相邻的空闲块可以合并,释放内存时会将它们合并为一个大块,减少碎片。 #### 比较 - **存储方式**:栈用于存储局部变量和函数调用信息,堆用于动态分配内存。 - **访问速度**:栈的访问速度快,堆的访问速度相对较慢。 - **内存管理**:栈由系统自动管理,堆由程序员管理。 - **空间大小**:栈空间有限,堆空间较大但易碎片化。 ### 总结 栈和堆在内存管理中扮演不同的角色。栈用于函数调用和局部变量,具有快速访问和自动管理的优势,但空间有限;堆用于动态内存分配,提供灵活性但需要手动管理,且易碎片化。在编程中,根据需求选择合适的内存分配方式可以提高程序的效率和性能。编辑于 2024-03-21 10:49 •IP属地 北京举报评论收藏
 不必太张扬,是花自然香。ketty### 数据结构的栈和堆 首先在数据结构上要知道堆栈,尽管我们这么称呼它,但实际上堆栈是两种数据结构:堆和栈。 堆和栈都是一种数据项按序排列的数据结构。 #### 栈就像装数据的桶或箱子 我们先从大家比较熟悉的栈说起吧,它是一种具有后进先出性质的数据结构,也就是说后存放的先取,先存放的后取。 这就如同我们要取出放在箱子里面底下的东西(放入的比较早的物体),我们首先要移开压在它上面的物体(放入的比较晚的物体)。 #### 堆像一棵倒过来的树 而堆就不同了,堆是一种经过排序的树形数据结构,每个结点都有一个值。 通常我们所说的堆的数据结构,是指二叉堆。 堆的特点是根结点的值最小(或最大),且根结点的两个子树也是一个堆。 由于堆的这个特性,常用来实现优先队列,堆的存取是随意,这就如同我们在图书馆的书架上取书,虽然书的摆放是有顺序的,但是我们想取任意一本时不必像栈一样,先取出前面所有的书,书架这种机制不同于箱子,我们可以直接取出我们想要的书。 ### 内存分配中的栈和堆 先看百度百科中的内存堆栈介绍: 堆栈空间分配 ``` 栈(操作系统):由操作系统自动分配释放 ,存放函数的参数值,局部变量的值等。其操作方式类似于数据结构中的栈。 堆(操作系统): 一般由程序员分配释放, 若程序员不释放,程序结束时可能由OS回收,分配方式倒是类似于链表。 ``` 堆栈缓存方式 栈使用的是一级缓存, 他们通常都是被调用时处于存储空间中,调用完毕立即释放。 堆则是存放在二级缓存中,生命周期由虚拟机的垃圾回收算法来决定(并不是一旦成为孤儿对象就能被回收)。所以调用这些对象的速度要相对来得低一些。 下面就说说C语言程序内存分配中的堆和栈,这里有必要把内存分配也提一下,大家不要嫌我啰嗦,一般情况下程序存放在Rom(只读内存,比如硬盘)或Flash中,运行时需要拷到RAM(随机存储器RAM)中执行,RAM会分别存储不同的信息,如下图所示: 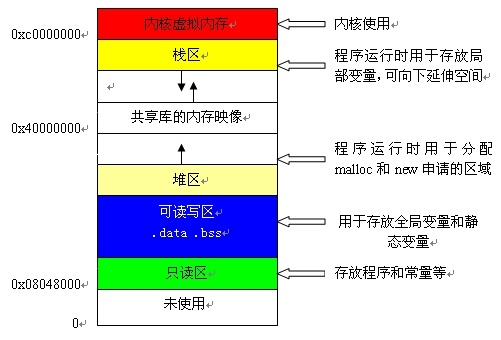 内存中的栈区处于相对较高的地址以地址的增长方向为上的话,栈地址是向下增长的。 栈中分配局部变量空间,堆区是向上增长的用于分配程序员申请的内存空间。另外还有静态区是分配静态变量,全局变量空间的;只读区是分配常量和程序代码空间的;以及其他一些分区。 来看一个网上很流行的经典例子: ``` int a = 0; //全局初始化区 char *p1; //全局未初始化区 main() { int b; //栈 char s[] = "abc"; //栈 char *p2; //栈 char *p3 = "123456"; //123456\0在常量区,p3在栈上。 static int c =0; //全局(静态)初始化区 p1 = (char *)malloc(10); //堆 p2 = (char *)malloc(20); //堆 } ``` 0.申请方式和回收方式不同 不知道你是否有点明白了。 堆和栈的第一个区别就是申请方式不同:栈(英文名称是stack)是系统自动分配空间的,例如我们定义一个 char a;系统会自动在栈上为其开辟空间。而堆(英文名称是heap)则是程序员根据需要自己申请的空间,例如malloc(10);开辟十个字节的空间。 由于栈上的空间是自动分配自动回收的,所以栈上的数据的生存周期只是在函数的运行过程中,运行后就释放掉,不可以再访问。而堆上的数据只要程序员不释放空间,就一直可以访问到,不过缺点是一旦忘记释放会造成内存泄露。还有其他的一些区别我认为网上的朋友总结的不错这里转述一下: 1.申请后系统的响应 栈:只要栈的剩余空间大于所申请空间,系统将为程序提供内存,否则将报异常提示栈溢出。 堆:首先应该知道操作系统有一个记录空闲内存地址的链表,当系统收到程序的申请时,会遍历该链表,寻找第一个空间大于所申请空间的堆结点,然后将该结点从空闲结点链表中删除,并将该结点的空间分配给程序,另外,对于大多数系统,会在这块内存空间中的首地址处记录本次分配的大小,这样,代码中的 delete语句才能正确的释放本内存空间。另外,由于找到的堆结点的大小不一定正好等于申请的大小,系统会自动的将多余的那部分重新放入空闲链表中。 也就是说堆会在申请后还要做一些后续的工作这就会引出申请效率的问题。 2.申请效率的比较 根据第0点和第1点可知。 栈:由系统自动分配,速度较快。但程序员是无法控制的。 堆:是由new分配的内存,一般速度比较慢,而且容易产生内存碎片不过用起来最方便。 3.申请大小的限制 栈:在Windows下栈是向低地址扩展的数据结构,是一块连续的内存的区域。这句话的意思是栈顶的地址和栈的最大容量是系统预先规定好的,在 WINDOWS下,栈的大小是2M(也有的说是1M,总之是一个编译时就确定的常数),如果申请的空间超过栈的剩余空间时,将提示overflow。因此,能从栈获得的空间较小。 堆:堆是向高地址扩展的数据结构,是不连续的内存区域。这是由于系统是用链表来存储的空闲内存地址的,自然是不连续的,而链表的遍历方向是由低地址向高地址。堆的大小受限于计算机系统中有效的虚拟内存。由此可见,堆获得的空间比较灵活,也比较大。 4.堆和栈中的存储内容 由于栈的大小有限,所以用子函数还是有物理意义的,而不仅仅是逻辑意义。 栈: 在函数调用时,第一个进栈的是主函数中函数调用后的下一条指令(函数调用语句的下一条可执行语句)的地址,然后是函数的各个参数,在大多数的C编译器中,参数是由右往左入栈的,然后是函数中的局部变量。注意静态变量是不入栈的。 当本次函数调用结束后,局部变量先出栈,然后是参数,最后栈顶指针指向最开始存的地址,也就是主函数中的下一条指令,程序由该点继续运行。 堆:一般是在堆的头部用一个字节存放堆的大小。堆中的具体内容有程序员安排。 5.存取效率的比较 ``` <span stchar s1[] = "aaaaaaaaaaaaaaa"; char *s2 = "bbbbbbbbbbbbbbbbb"; ``` aaaaaaaaaaa是在运行时刻赋值的;放在栈中。 而bbbbbbbbbbb是在编译时就确定的;放在堆中。 但是,在以后的存取中,在栈上的数组比指针所指向的字符串(例如堆)快。 比如: ``` #include void main() { char a = 1; char c[] = "1234567890"; char *p ="1234567890"; a = c[1]; a = p[1]; return; } ``` 对应的汇编代码 10: a = c[1]; 00401067 8A 4D F1 mov clbyte ptr [ebp-0Fh] 0040106A 88 4D FC mov byte ptr [ebp-4]cl 11: a = p[1]; 0040106D 8B 55 EC mov edxdword ptr [ebp-14h] 00401070 8A 42 01 mov albyte ptr [edx+1] 00401073 88 45 FC mov byte ptr [ebp-4]al 关于堆和栈区别的比喻 堆和栈的区别可以引用一位前辈的比喻来看出: 使用栈就象我们去饭馆里吃饭,只管点菜(发出申请)、付钱、和吃(使用),吃饱了就走,不必理会切菜、洗菜等准备工作和洗碗、刷锅等扫尾工作,他的好处是快捷,但是自由度小。 使用堆就象是自己动手做喜欢吃的菜肴,比较麻烦,但是比较符合自己的口味,而且自由度大。比喻很形象,说的很通俗易懂,不知道你是否有点收获。编辑于 2022-12-08 13:04 •IP属地 云南举报评论收藏
 用顺其自然态度过随遇而安的生活.小王子-B613堆和栈是两种内存分配的两个统称。可能有很多种不同的实现方式,但是实现要符合几个基本的概念: 1.对栈而言,栈中的新加数据项放在其他数据的顶部,移除时你也只能移除最顶部的数据(不能越位获取)。 2.对堆而言,数据项位置没有固定的顺序。你可以以任何顺序插入和删除,因为他们没有“顶部”数据这一概念。 上面上个图片很好的描述了堆和栈分配内存的方式。 在通常情况下由操作系统(OS)和语言的运行时(runtime)控制吗? 如前所述,堆和栈是一个统称,可以有很多的实现方式。计算机程序通常有一个栈叫做调用栈,用来存储当前函数调用相关的信息(比如:主调函数的地址,局部变量),因为函数调用之后需要返回给主调函数。栈通过扩展和收缩来承载信息。实际上,程序不是由运行时来控制的,它由编程语言、操作系统甚至是系统架构来决定。 堆是在任何内存中动态和随机分配的(内存的)统称;也就是无序的。内存通常由操作系统分配,通过应用程序调用 API 接口去实现分配。在管理动态分配内存上会有一些额外的开销,不过这由操作系统来处理。 它们的作用范围是什么? 调用栈是一个低层次的概念,就程序而言,它和“作用范围”没什么关系。如果你反汇编一些代码,你就会看到指针引用堆栈部分。就高级语言而言,语言有它自己的范围规则。一旦函数返回,函数中的局部变量会直接直接释放。你的编程语言就是依据这个工作的。 在堆中,也很难去定义。作用范围是由操作系统限定的,但是你的编程语言可能增加它自己的一些规则,去限定堆在应用程序中的范围。体系架构和操作系统是使用虚拟地址的,然后由处理器翻译到实际的物理地址中,还有页面错误等等。它们记录那个页面属于那个应用程序。不过你不用关心这些,因为你仅仅在你的编程语言中分配和释放内存,和一些错误检查(出现分配失败和释放失败的原因)。 它们的大小由什么决定? 依旧,依赖于语言,编译器,操作系统和架构。栈通常提前分配好了,因为栈必须是连续的内存块。语言的编译器或者操作系统决定它的大小。不要在栈上存储大块数据,这样可以保证有足够的空间不会溢出,除非出现了无限递归的情况(额,栈溢出了)或者其它不常见了编程决议。 堆是任何可以动态分配的内存的统称。这要看你怎么看待它了,它的大小是变动的。在现代处理器中和操作系统的工作方式是高度抽象的,因此你在正常情况下不需要担心它实际的大小,除非你必须要使用你还没有分配的内存或者已经释放了的内存。 哪个更快一些? 栈更快因为所有的空闲内存都是连续的,因此不需要对空闲内存块通过列表来维护。只是一个简单的指向当前栈顶的指针。编译器通常用一个专门的、快速的寄存器来实现。更重要的一点事是,随后的栈上操作通常集中在一个内存块的附近,这样的话有利于处理器的高速访问(译者注:局部性原理)。发布于 2022-12-04 16:54 •IP属地 山东举报评论收藏
 自己喜欢的东西,就不要问别人好不好。粑粑栈是为执行线程留出的内存空间。当函数被调用的时候,栈顶为局部变量和一些 bookkeeping 数据预留块。当函数执行完毕,块就没有用了,可能在下次的函数调用的时候再被使用。栈通常用后进先出(LIFO)的方式预留空间;因此最近的保留块(reserved block)通常最先被释放。这么做可以使跟踪堆栈变的简单;从栈中释放块(free block)只不过是指针的偏移而已。 堆(heap)是为动态分配预留的内存空间。和栈不一样,从堆上分配和重新分配块没有固定模式;你可以在任何时候分配和释放它。这样使得跟踪哪部分堆已经被分配和被释放变的异常复杂;有许多定制的堆分配策略用来为不同的使用模式下调整堆的性能。 每一个线程都有一个栈,但是每一个应用程序通常都只有一个堆(尽管为不同类型分配内存使用多个堆的情况也是有的)。 直接回答你的问题: 1. 当线程创建的时候,操作系统(OS)为每一个系统级(system-level)的线程分配栈。通常情况下,操作系统通过调用语言的运行时(runtime)去为应用程序分配堆。 2. 栈附属于线程,因此当线程结束时栈被回收。堆通常通过运行时在应用程序启动时被分配,当应用程序(进程)退出时被回收。 3. 当线程被创建的时候,设置栈的大小。在应用程序启动的时候,设置堆的大小,但是可以在需要的时候扩展(分配器向操作系统申请更多的内存)。 4. 栈比堆要快,因为它存取模式使它可以轻松的分配和重新分配内存(指针/整型只是进行简单的递增或者递减运算),然而堆在分配和释放的时候有更多的复杂的 bookkeeping 参与。另外,在栈上的每个字节频繁的被复用也就意味着它可能映射到处理器缓存中,所以很快(译者注:局部性原理)。发布于 2022-12-01 20:19 •IP属地 河北举报评论收藏
 世界上有两个我,一个想去远方,一个身不由己。菜菜Stack: 和堆一样存储在计算机 RAM 中。 在栈上创建变量的时候会扩展,并且会自动回收。 相比堆而言在栈上分配要快的多。 用数据结构中的栈实现。 存储局部数据,返回地址,用做参数传递。 当用栈过多时可导致栈溢出(无穷次(大量的)的递归调用,或者大量的内存分配)。 在栈上的数据可以直接访问(不是非要使用指针访问)。 如果你在编译之前精确的知道你需要分配数据的大小并且不是太大的时候,可以使用栈。 当你程序启动时决定栈的容量上限。 Heap: 和栈一样存储在计算机RAM。 在堆上的变量必须要手动释放,不存在作用域的问题。数据可用 delete, delete[] 或者 free 来释放。 相比在栈上分配内存要慢。 通过程序按需分配。 大量的分配和释放可造成内存碎片。 在 C++ 中,在堆上创建数的据使用指针访问,用 new 或者 malloc 分配内存。 如果申请的缓冲区过大的话,可能申请失败。 在运行期间你不知道会需要多大的数据或者你需要分配大量的内存的时候,建议你使用堆。 可能造成内存泄露。发布于 2022-12-01 13:47 •IP属地 黑龙江举报评论收藏
公众号进入网站体验更佳
