
spring是如何解决循环依赖的?
```java
/**
* A 类,引入 B 类的属性 b
*/
public class A {
private B b;
}
/**
* B 类,引入 A 类的属性 a
*/
public class B {
private A a;
}
```
像这样,创建 a 的时候需要依赖 b,那就创建 b,结果创建 b 的时候又需要依赖 a,那就创建 a,创建 a 的时候需要依赖 b,那就创建 b,结果创建 b 的时候又需要依赖 a ……
互相依赖何时了,死循环了?
3 个回答
 二八佳人体似酥,腰间仗剑斩凡夫。小菜鸟### Spring 如何解决循环依赖(以 A 和 B 为例) 下面我们通过一个简单的例子来展示 Spring 是如何通过三级缓存机制解决循环依赖问题。 #### 示例代码 ```java // A 类,引入 B 类的属性 b public class A { private B b; // setter and getter public void setB(B b) { this.b = b; } public B getB() { return b; } } // B 类,引入 A 类的属性 a public class B { private A a; // setter and getter public void setA(A a) { this.a = a; } public A getA() { return a; } } ``` #### 解决循环依赖的流程 1. **初始化 A** - Spring 开始创建 A 的实例,并将 A 的 `ObjectFactory` 提前曝光,存入三级缓存 (`singletonFactories`)。 - 在初始化过程中,Spring 发现 A 依赖 B,于是开始创建 B。 2. **初始化 B** - Spring 开始创建 B 的实例,并将 B 的 `ObjectFactory` 提前曝光,存入三级缓存 (`singletonFactories`)。 - 在初始化过程中,Spring 发现 B 依赖 A,于是尝试从缓存中获取 A。 3. **解决循环依赖** - 由于 A 已经在三级缓存中提前曝光,Spring 通过 `ObjectFactory#getObject()` 方法获取 A 的实例,完成 B 的初始化,并将 B 放入一级缓存 (`singletonObjects`)。 - B 初始化完成后,Spring 回到 A 的初始化过程,此时可以从一级缓存中获取到 B 的实例,完成 A 的初始化,并将 A 放入一级缓存 (`singletonObjects`)。 #### 代码示例 为了展示这一流程,我们可以编写一个简单的 Spring 配置文件和一个测试类。 ##### Spring 配置文件(applicationContext.xml) ```xml <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd"> <bean id="a" class="com.example.A"> <property name="b" ref="b"/> </bean> <bean id="b" class="com.example.B"> <property name="a" ref="a"/> </bean> </beans> ``` ##### 测试类 ```java import org.springframework.context.ApplicationContext; import org.springframework.context.support.ClassPathXmlApplicationContext; public class Main { public static void main(String[] args) { ApplicationContext context = new ClassPathXmlApplicationContext("applicationContext.xml"); A a = (A) context.getBean("a"); B b = (B) context.getBean("b"); System.out.println("A's B: " + a.getB()); System.out.println("B's A: " + b.getA()); } } ``` #### 总结 Spring 通过以下步骤解决循环依赖问题: 1. **提前曝光**:在 Bean 初始化的早期阶段,将 Bean 的创建过程中的代理对象存放到三级缓存中 (`singletonFactories`)。 2. **三级缓存机制**: - **singletonObjects**:一级缓存,存放完全初始化好的单例 Bean。 - **earlySingletonObjects**:二级缓存,存放提前曝光的单例 Bean 实例,用于解决循环依赖。 - **singletonFactories**:三级缓存,存放能够创建 Bean 实例的工厂对象 `ObjectFactory`。 3. **解决循环依赖**:通过三级缓存机制,在 Bean 的创建过程中即使遇到循环依赖,也可以通过提前曝光的 `ObjectFactory` 获取到相关依赖的 Bean 实例,从而完成整个 Bean 的初始化过程。 通过这种机制,Spring 可以确保在初始化 Bean 时,即使存在循环依赖,也能够顺利地完成 Bean 的创建和初始化。编辑于 2022-03-03 07:52 •IP属地 北京举报评论收藏
 在漆黑的夜里,你需要一道光照亮夜行的路,我燃烧了我自己,但也造就了你我不能相拥。蚂蚱Spring IOC只能解决属性注入之间的循环依赖问题,如果是构造器之间的循环依赖,只会抛出BeanCurrentlyInCreationException异常。 Spring使用了3个Map来保存Bean,俗称为三级依赖: singletonObjects 一级缓存,用于保存实例化、注入、初始化完成的bean实例,可以使用的。 earlySingletonObjects 二级缓存,bean刚刚构造完成,但是还没有进行属性填充。 singletonFactories 三级缓存,用于保存正在创建中的bean,以便于后面扩展有机会创建代理对象,此时的bean是没有完成属性填充的。 假设A类和B类相互依赖,A中有一个B类的属性,B中有一个A类的属性。那么在初始化A的Bean时,首先会依次去一级依赖,去二级依赖,三级依赖中去找,都没有就调用创建方法创建实例A,将A添加到三级依赖中,然后对A的属性进行依赖注入,填充属性时,发现B的Bean在各级依赖中都没有,就创建B的bean添加到三级依赖,然后对B的属性进行填充,填充B的属性A时,会从三级依赖中取出A,填充完放到二级依赖,然后对B进行初始化,初始化完成添加到一级依赖。B初始化完成后,将B从一级依赖中,填充到实例A,A可以进入到二级依赖,完全初始化完成后,A进入到一级依赖,供用户代码使用。 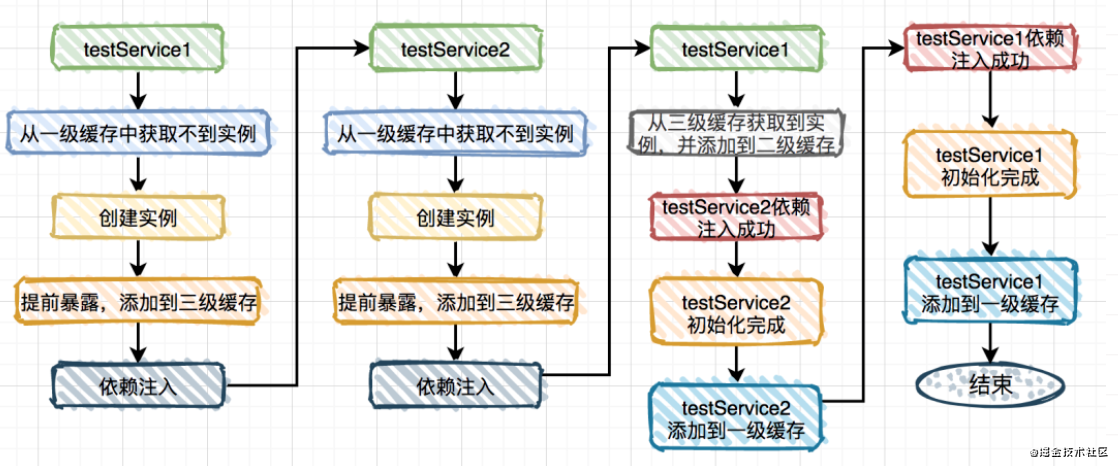发布于 2021-11-24 20:03 •IP属地 安徽举报评论收藏
 重新审视自己,什么使你快乐,什么就是眼下最珍贵。大小姐手动解决循环依赖的方式:先都new出来,再set. ```java A a = new A(); B b = new B(); b.setA(a); a.setB(b); ``` Spring 也使用 set 注入的方式解决的。不过set之前先要通过反射将对象加载进来。 - 1.先实例化 A 类 - 2.再实例化 B 类 - 3.set B 类中的 a 属性 - 4.set A 类中的 b 属性 **Spring 如何解决循环依赖问题** ```java /** * 单例对象的缓存:bean 名称——bean 实例,即:所谓的单例池。 * 表示已经经历了完整生命周期的 Bean 对象 * <b>第一级缓存</b> */ Map<String, Object> singletonObjects = new ConcurrentHashMap<>(256); /** * 早期的单例对象的高速缓存:bean 名称——bean 实例。 * 表示 Bean 的生命周期还没走完(Bean 的属性还未填充)就把这个 Bean 存入该缓存中 * 也就是实例化但未初始化的 bean 放入该缓存里 * <b>第二级缓存</b> */ Map<String, Object> earlySingletonObjects = new HashMap<>(16); /** * 单例工厂的高速缓存:bean 名称——ObjectFactory。 * 表示存放生成 bean 的工厂 * <b>第三级缓存</b> */ Map<String, ObjectFactory<?>> singletonFactories = new HashMap<>(16); ``` 代码中注释可能不清晰,我再给贴一下三级缓存: 第一级缓存(也叫单例池):Map<String, Object> singletonObjects,存放已经经历了完整生命周期的 Bean 对象 第二级缓存:Map<String, Object> earlySingletonObjects,存放早期暴露出来的 Bean 对象,Bean 的生命周期未结束(属性还未填充完) 第三级缓存:Map<String, ObjectFactory<?>> singletonFactories,存放可以生成 Bean 的工厂Spring 管理的 Bean 其实默认都是单例的,也就是说 Spring 将最终可以使用的 Bean 统一放入第一级缓存中,也就是 singletonObjects(单例池)里,以后凡是用到某个 Bean 了都从这里获取就行了。 **为啥要使用多级缓存呢?** 既然都从 singletonObjects 里获取,那么仅仅使用这一个 singletonObjects,可以吗?肯定不可以的。 首先 singletonObjects 存入的是完全初始化好的 Bean,可以拿来直接用的。 如果我们直接将未初始化完的 Bean 放在 singletonObjects 里面,注意,这个未初始化完的 Bean 极有可能会被其他的类拿去用,它都没完事呢,就被拿去造了,肯定要出事啊! **总结:** 第二级缓存就可以解决循环依赖的问题。 第三级缓存其实是为了解决代理问题。 **最后spring并没有解决所有循环依赖的场景**: 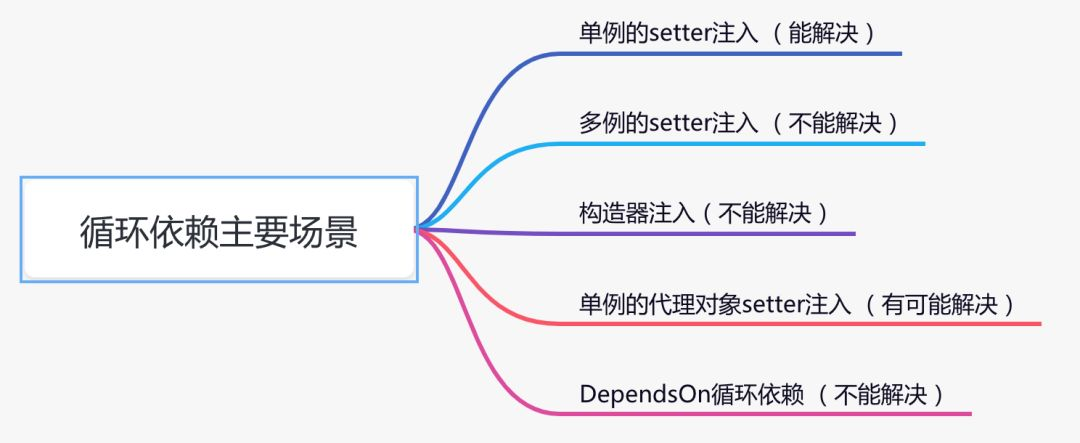编辑于 2021-06-17 16:35 •IP属地 天津举报评论收藏
公众号进入网站体验更佳
