
es写入过程是什么样的?
面试题~
2 个回答
 想多了全是问题,想开了全是答案。Rose的肉丝儿### Elasticsearch 写入过程详解 Elasticsearch(ES)集群中任意节点都可以作为协调节点(coordinating node)来接受客户端的请求。当协调节点接受到写入请求后,会进行一系列处理,然后通过 `_routing` 字段找到对应的主分片(primary shard),并将请求转发给主分片。主分片完成写入操作后,会将写入请求并发发送给各个副本分片(replica shard)。副本分片执行写入操作后返回给主分片,主分片再将处理结果返回给协调节点。大致流程如下图所示: 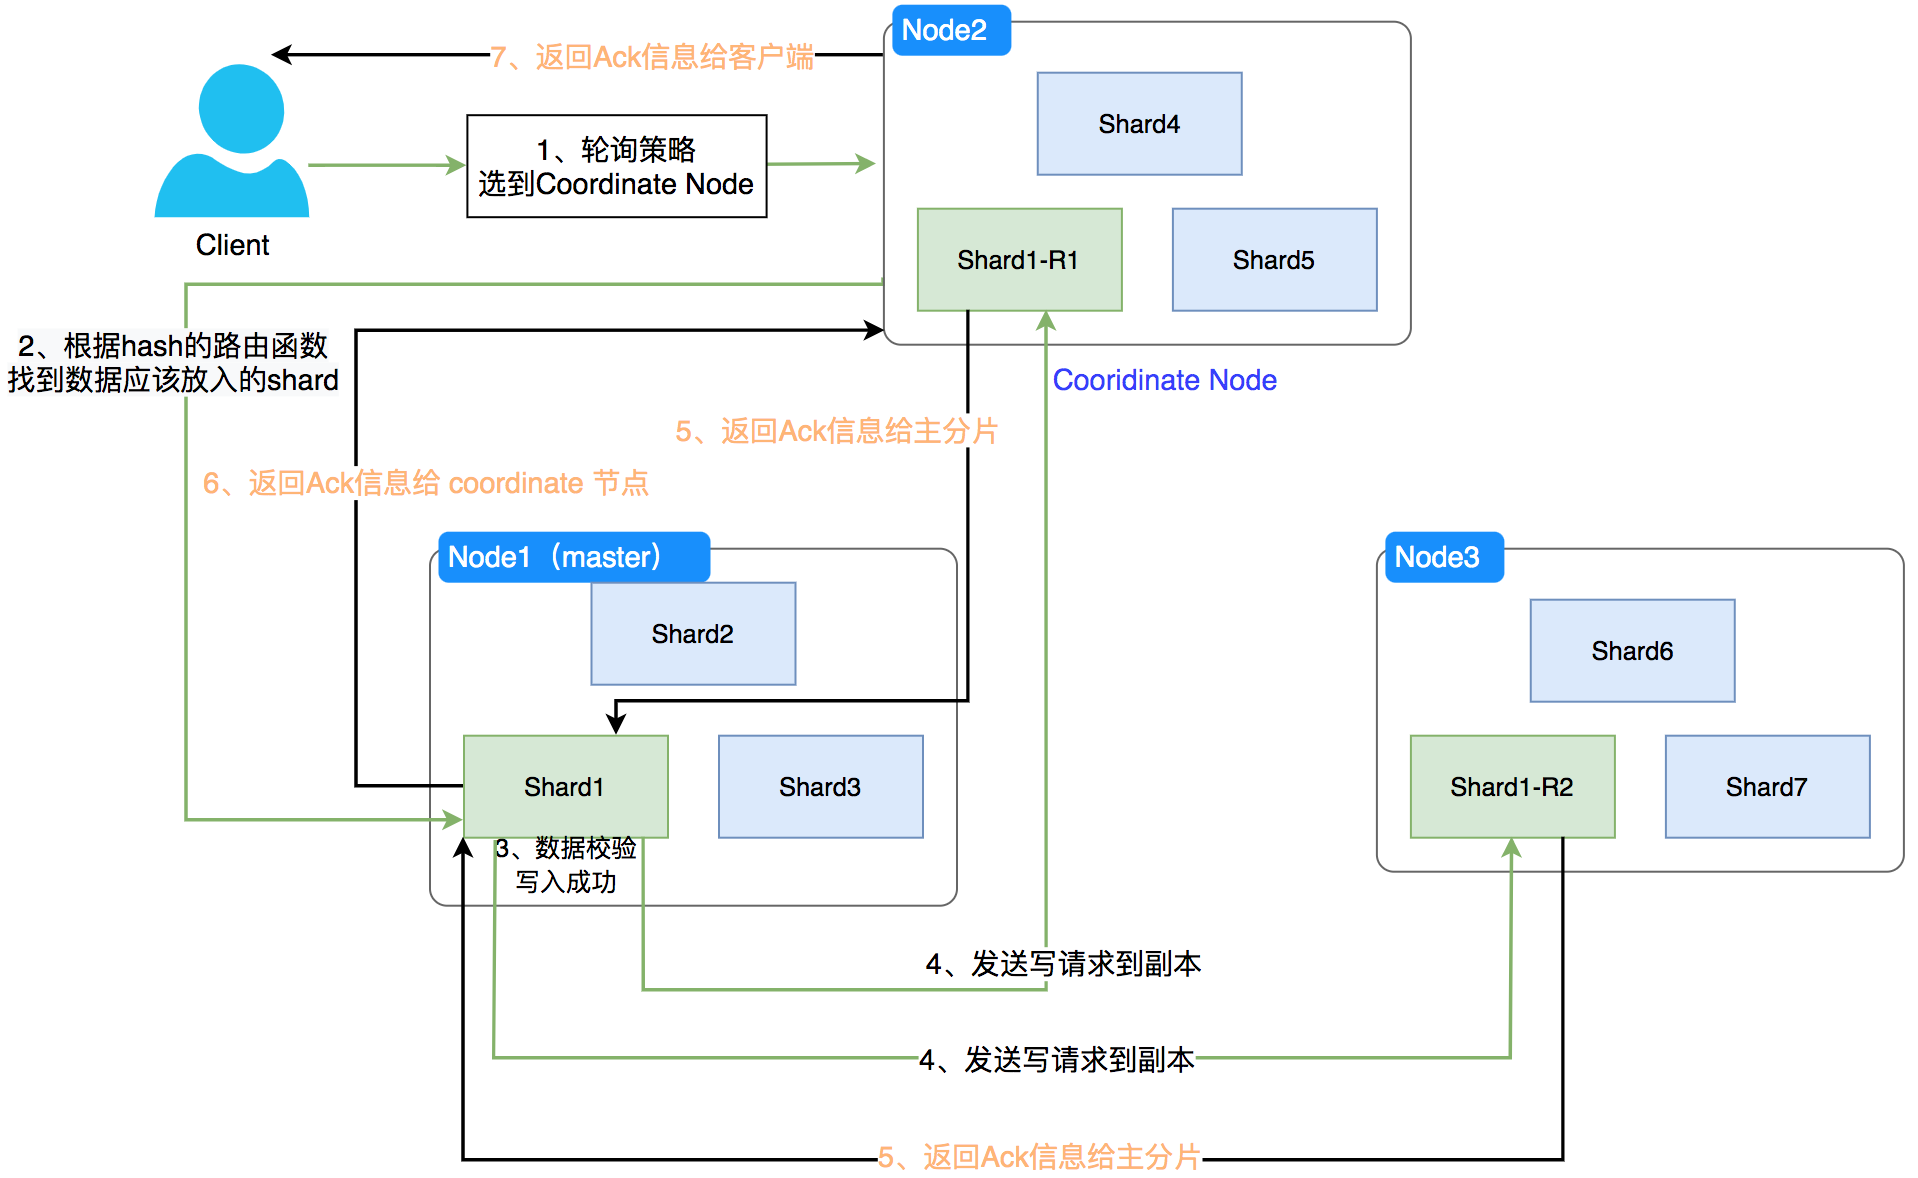 #### 写数据过程 1. **客户端发送请求**:客户端将写入请求发送到 ES 集群中的任意一个节点。 2. **协调节点处理请求**:该节点作为协调节点接受请求,对请求进行预处理。 3. **路由到主分片**:协调节点根据 `_routing` 字段找到对应的主分片,并将请求转发给主分片。 4. **主分片写入数据**:主分片执行写入操作,将数据写入内存 buffer 和 translog 日志文件。 5. **同步到副本分片**:主分片将写入请求并发发送给所有副本分片,副本分片执行相同的写入操作。 6. **副本分片返回结果**:副本分片完成写入后,返回结果给主分片。 7. **主分片返回结果**:主分片在收到所有副本分片的响应后,将结果返回给协调节点。 8. **协调节点反馈客户端**:协调节点最终将处理结果反馈给客户端。 #### 写数据的底层原理 1. **写入内存和日志**:数据到达主分片时,首先写入内存 buffer,同时生成一个 translog 日志文件,将数据写入 translog。 2. **内存 buffer 刷新**:如果内存 buffer 空间接近满了,或者每隔 1 秒,buffer 里的数据会被刷新到一个新的 segment 文件中,并生成倒排索引。刷新后的数据可以被搜索到。 3. **写入操作系统缓存**:在 buffer 刷新到 segment 文件之前,数据会先进入操作系统缓存(os cache),一旦刷新操作执行,数据就可以被搜索到,buffer 会被清空。 4. **数据提交**:新的数据不断进入 buffer 和 translog。当 translog 达到一定长度时,会触发 commit 操作。commit 操作包括将 buffer 中的数据刷新到 os cache 中,清空 buffer,translog 刷入磁盘。 5. **定期刷新和合并**:每隔 30 分钟自动执行 flush 操作。每次 refresh 产生一个 segment 文件,当 segment 文件达到一定数量时,触发 merge 操作,将多个 segment 文件合并为一个,并删除已标记为删除的文档。 ### 基本写模型 1. **路由选择**:每个索引操作首先通过路由选择定位到一个复制组,默认基于文档 ID(routing),其基本算法为 `hash(routing) % (primary count)`。 2. **主分片验证和转发**:操作被转发到该组的主分片(primary shard)。主分片验证操作,将其转发到当前同步副本集(in-sync)的每个副本。 3. **并行执行**:如果有多个副本,操作会并行执行。一旦所有副本成功执行,主分片向客户端返回成功。 ### 异常处理机制 在索引过程中可能引发的异常情况及处理机制: 1. **副本操作失败**:主分片在指定时间内未收到副本的成功响应或收到错误响应,会请求 Master 节点删除有问题的副本,并指示另一个节点开始构建新的分片副本。 2. **主分片不可用**:触发复制组内的主分片选举,新的主节点选出后向 Master 服务器发送消息,请求转发到新的主服务器处理,请求在选主期间会阻塞,默认最多等待 1 分钟。 3. **网络分区问题**:主分片在意识到自己被降级前,可能继续处理传入的索引操作并转发到副本,副本会拒绝来自陈旧主服务器的操作。 ### 无副本场景 在没有副本的情况下,主分片会在没有外部验证的情况下处理操作。Master 节点会知道主分片是该复制组唯一的可用拷贝,不会将其他副本提升为新的主分片,确保数据一致性,但也意味着只有单一的数据副本,物理硬件问题可能导致数据丢失。 ### 总结 Elasticsearch 通过协调节点、主分片和副本分片的协作,实现了高效的写入和数据同步。通过合理的配置和优化,能够在保障性能的同时,提高数据的可靠性和可用性。在实际应用中,理解这些底层机制有助于更好地使用 Elasticsearch,并在发生异常时采取有效的处理措施。 注:在一个 Elasticsearch 集群中,存在两个维度的选主:Master 节点的选主和各个复制组主分片的选主。编辑于 2024-01-03 16:07 •IP属地 北京举报评论收藏
 明知不可为而为之就是我最大的诚意夜太#### 写数据过程 1. **客户端发送请求**:客户端通过哈希选择一个节点发送请求,这个节点被称作协调节点(coordinating node)。 2. **协调节点路由请求**:协调节点根据文档 ID 进行路由,将请求转发到对应的主分片(primary shard)。 3. **主分片处理请求**:主分片处理请求,并将数据同步到所有的副本分片(replica shard)。 4. **反馈客户端**:协调节点在确认主分片和所有副本分片都处理完请求后,反馈结果给客户端。 #### 写数据的底层原理 1. **写入内存和日志**:当数据到达主分片时,首先写入内存 buffer,同时生成一个 translog 日志文件,将数据写入 translog。 2. **内存 buffer 刷新**:如果内存 buffer 空间接近满了,或者每隔 1 秒,buffer 里的数据会被刷新到一个新的 segment 文件中,并生成倒排索引。刷新后的数据可以被搜索到。 3. **写入操作系统缓存**:在 buffer 刷新到 segment 文件之前,数据会先进入操作系统缓存(os cache),一旦刷新操作执行,数据就可以被搜索到,buffer 会被清空。 4. **数据提交**:新的数据不断进入 buffer 和 translog。当 translog 达到一定长度时,会触发 commit 操作。commit 操作包括将 buffer 中的数据刷新到 os cache 中,清空 buffer,translog 刷入磁盘。 5. **定期刷新和合并**:每隔 30 分钟自动执行 flush 操作。每次 refresh 产生一个 segment 文件,当 segment 文件达到一定数量时,触发 merge 操作,将多个 segment 文件合并为一个,并删除已标记为删除的文档。 ### 基本写模型 1. **路由选择**:每个索引操作首先通过路由选择定位到一个复制组,默认基于文档 ID(routing),其基本算法为 `hash(routing) % (primary count)`。 2. **主分片验证和转发**:操作被转发到该组的主分片(primary shard)。主分片验证操作,将其转发到当前同步副本集(in-sync)的每个副本。 3. **并行执行**:如果有多个副本,操作会并行执行。一旦所有副本成功执行,主分片向客户端返回成功。 ### 异常处理机制 在索引过程中可能引发的异常情况及处理机制: 1. **副本操作失败**:主分片在指定时间内未收到副本的成功响应或收到错误响应,会请求 Master 节点删除有问题的副本,并指示另一个节点开始构建新的分片副本。 2. **主分片不可用**:触发复制组内的主分片选举,新的主节点选出后向 Master 服务器发送消息,请求转发到新的主服务器处理,请求在选主期间会阻塞,默认最多等待 1 分钟。 3. **网络分区问题**:主分片在意识到自己被降级前,可能继续处理传入的索引操作并转发到副本,副本会拒绝来自陈旧主服务器的操作。 ### 无副本场景 在没有副本的情况下,主分片会在没有外部验证的情况下处理操作。Master 节点会知道主分片是该复制组唯一的可用拷贝,不会将其他副本提升为新的主分片,确保数据一致性,但也意味着只有单一的数据副本,物理硬件问题可能导致数据丢失。 ### 总结 Elasticsearch 通过协调节点、主分片和副本分片的协作,实现了高效的写入和数据同步。通过合理的配置和优化,能够在保障性能的同时,提高数据的可靠性和可用性。在实际应用中,理解这些底层机制有助于更好地使用 Elasticsearch,并在发生异常时采取有效的处理措施。 注:在一个 Elasticsearch 集群中,存在两个维度的选主:Master 节点的选主和各个复制组主分片的选主。编辑于 2023-12-16 23:03 •IP属地 北京举报评论收藏
公众号进入网站体验更佳
