
Java8 并行流原理是什么?
2 个回答
 用眼睛是看不到事物的本质的,只有心灵才能够洞察一切。helloStream利用的管道思想其实在很多框架中也能看到,比如Netty、RxJava。我在17年的时候有去看过RxJava的源码,那时是用来做安卓开发解决线程切换问题的,因为页面的渲染只能在主线程,但是那时候读源码很是头大,后面放弃了。做后端之后就没再用过RxJava。 看了网上有挺多分析stream源码的文章的,所以我也不打算跟大家分析stream的源码,至于并行流parallelStream,网上没能找到能说清楚的文章,但是我自己也没理解清楚,所以还是得靠自己啊。今天主要说的是使用parallelStream的一些注意细节,看了之后不要再踩这些坑了哦。 Parallel Stream实现任务的切分,并将任务提交到全局的ForkJoinPool线程池中执行,注意,是全局的线程池。关于ForkJoinPool,我这里简单介绍下。 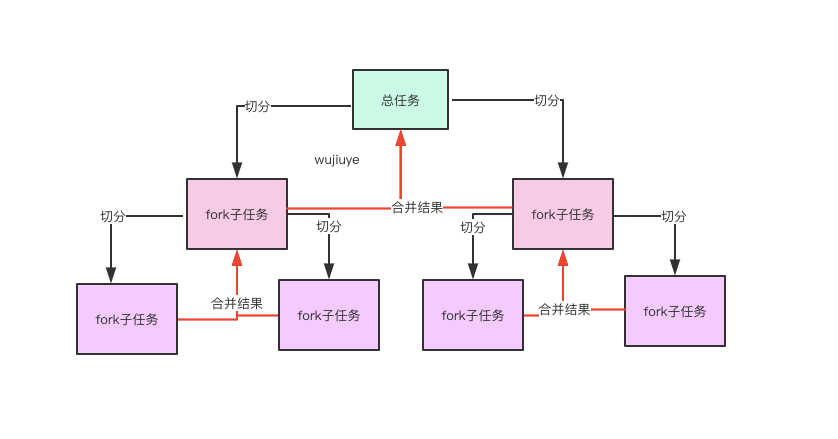 本来想偷懒,直接去网上找张图的。网上画的图很好看,但我觉得并没有画出Fork-Join这两个词的真正含义。只可意会不可言传哪。 我的理解范围内,Fork-Join的最大特点是分治思想,与Hadoop的MapReduce(这个单词写对了吗)一个原理,其实如果用过归并排序算法的,也能看出,这跟归并排序算法很像。 关于工作窃取机制,这应该是go语言协程里的概念。在Fork-Join中,比如一个拥有4个线程的ForkJoinPool线程池,有一个任务队列,一个大的任务切分出的子任务会提交到线程池的任务队列中,4个线程从任务队列中获取任务执行,哪个线程执行的任务快,哪个线程执行的任务就多,只有队列中没有任务线程才是空闲的,这就是工作窃取。可以这样理解工作窃取,比如有4个人干8件事情,理应每个人干2件,但干活快的干完自己的事情后可以去帮别人干。 正如图中所示,一个任务可以fork中很多个子任务,当然不只是图中看到的只有左右两个。假设,每个任务都只fork出两个子任务,如果负责fork子任务的当前任务不做任何事情,那么最终将只有叶子节点真正做事情,其它节点都只是负责fork子任务与合并结果(假设是有返回值的任务)。 如果是没有返回值的任务,是没有图中“合并结果”这个流程的;而且,也不是必须要等待子任务执行完成。这些都是根据自己的需求来自定义使用的。要灵活去使用。 比如,处理一个1+2+3+....+100的加法运算任务,就需要获取返回值,而切分任务我们可以这样切分:每次除2切分左右两个子任务,如100/2=50,1到50的相加由左子任务完成,51到100的由右子任务完成,1到50同理继续除2切分出子任务,切到只剩一个数的时候就返回。没错,我说的就是归并算法。核心逻辑代码实现如下。 ```java // 分治 MyForkTask leftTask = new MyForkTask(numbers); leftTask.fork(); MyForkTask rightTask = new MyForkTask(numbers); rightTask.fork(); // 等待子任务完成,合并结果 count += leftNextPullTask.join(); count += rightNextPullTask.join(); ``` 对了,既然是线程池,那肯定是要提交任务。前面说了Fork-Join支持切分的任务分有返回值和没有返回值两种,任务是分别对应实现RecursiveTask接口与RecursiveAction接口。关于Fork-Join就说这么多吧。 重点说下Parallel Stream并行流使用的一些坑。一个是使用.parallelStream()之后,在接下来的管道中做任何业务逻辑都需要确保线程安全,比如。 ```java List<Int..> result = new ArrayList<>(); tmpList.parallerStream() .foEach(item -> { .....(微信公众号:Java艺术) result.add(item); }); ``` 由于ArrayList并不是线程安全的,这样使用就会出现线程安全问题,所以注意了,使用parallerStream必须确保线程安全问题。 可能很多人都像我一样,自从用了stearm之后就很少写for循环了,这不是一个好的习惯。比如我只是简单的遍历一遍int数组,那就不要使用stearm,直接使用for循环性能会更好,因为stream你只是用着简单,但你看下源码,封装很多复杂逻辑,原本只是简单的数组遍历,你用stream之后将会创建出很多中间对象,还有一大堆的流式调用逻辑。 你以为这样就完了吗?还有更恐怖的线程安全问题。在并发量高的接口中不要直接使用stream的parallerStream处理耗时的逻辑,因为并行流运行时,内部使用的fork-join线程池是整个JVM进程全局唯一的线程池。而这个线程池其默认线程数为处理器核心数。 ```java Run``` ``` time.getRuntime().availableProcessors() ``` 可以通过配置修改这个值 。 ```java System.setProperty("java.util.concurrent.ForkJoinPool.common.parallelism","12"); ``` 一般不建议修改,最好是自己创建一个Fork-Join线程池来用,因为你如果改了,虽然对你当前的业务逻辑来说,算是调优了,但对于项目中其它地方只是用来做非耗时的并行流运算,性能就差了。 对的,由于所有使用并行流parallerStream的地方都是使用同一个Fork-Join线程池,而线程池线程数仅为cpu的核心数。我们可以来写个例子验证是不是整个java进程使用的parallerStream都是用的同一个进程,我这里提供例子,不相信的可以自己拿去跑下看看。 ```java /** * @author wujiuye * @version 1.0 on 2019/9/25 {描述:} */ public class PStream { public static void main(String[] args) throws InterruptedException { final List<Integer> list = new ArrayList<>(100); for (int i = 0; i < 100; i++) { list.add(1); } for (int i = 1; i <= 50; i++) { new Thread("test-" + i) { String currentThreaName = this.getName(); @Override public void run() { list.parallelStream() .forEach(numbser -> { Thread c = Thread.currentThread(); System.out.println(currentThreaName + "===> " + c.getClass().getName() + ":" + c.getName() + ":" + c.getId()); try { Thread.sleep(10); } catch (InterruptedException e) { e.printStackTrace(); } }); } }.start(); } Thread.sleep(Integer.MAX_VALUE); } } ``` 程序运行结果部分截图 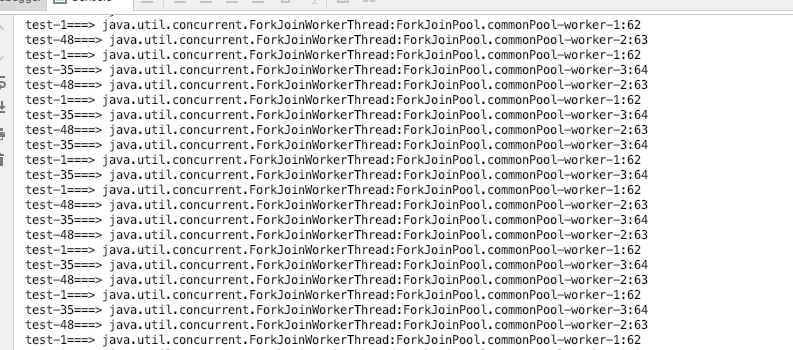 你可能会被线程id62、63、64吓到,因为for循环创建了50个线程,jvm启动后自身也会创建一些线程,比如gc线程。所以全局Fork-Join线程池的线程id是从62开始的几个。 你还可以去调试看源码。 ```java 对应forEach流 ForEachOps::compute方法打个断点, 或者直接forEach方法的输出语句打个断点,找到ForkJoinWorkerThread类 public class ForkJoinWorkerThread extends Thread { final ForkJoinPool pool; // the pool this thread works in final ForkJoinPool.WorkQueue workQueue; // work-stea public void run() { .... (微信公众号:Java艺术) pool.runWorker(workQueue); ...... } } ``` 假设,分布式服务中(rpx框架:dubbo),有一个接口,用于批量处理数据,如果每次消费者调用都用了批量处理1000条记录的过滤,假设一条记录的过滤逻辑需要耗时4ms( 涉及到redis缓存的读),如果有40个请求并发过滤,那就是40000条记录交给2个线程去处理(cpu核心线程数),你猜下结果是什么?结果是,服务消费端报错,一堆的接口调用超时异常,导致服务雪崩。后果很严重。原因你猜到了吗? 40个请求开启40个并行流parallerStream,40个并行流parallerStream使用同一个只有2个线程的Fork-Join线程池(2核8g机器),意味着40个请求争抢着执行任务。 假设一条记录的过滤耗时为4ms,在串行的情况下1000条记录应该只是4000ms。但如果是400000条记录争抢2个线程执行,我们转变一下,假设每线程每200000记录执行,由于是无序的,但可以想象对请求来说任务是被交替执行完成的。什么意思呢,比如当前执行1号请求的第一个任务,执行完后切换到2号个请求的第一个任务,接着3号请求的第一个任务,一轮完成后接着是1号请求的第二个任务...所以,最坏的情况下,一个请求需要200000*4ms才能执行完成。就会导致接口调用超时。 总之,不要在高并发的接口中使用并行流,直接使用处理请求的线程执行就行,如果有需要,那就全局创建一个Fork-Join线程池自己切分任务来执行。 刚刚说的例子只是40个并发,实现项目中都是上千上万的并发请求,如果这样使用并行流,服务直接崩掉。 假设用的dubbo默认配置200个工作线程,那么是200个线程处理业务逻辑快呢,还是将200个线程的请求都交给只有2个线程的线程池处理快呢?毫无疑问。 ### 总结 那些耗时很长的任务,请不要使用parallerStream。假设原本一个任务执行需要1分钟时间,有10个任务并行执行,如果你偷懒,只是使用parallerStream来将这10个任务并行执行,那你这个jvm进程中,其它同样使用parallerStream的地方也会因此被阻塞住,严重的将会导致整个服务瘫痪。 关于stream的并行流parallerStream使用注意事项就说到这。切记,请不要乱用并行流,在使用之前一定、一定、一定要考虑清楚任务是否耗时,有i/o操作的一定不要使用并行流,有线程休眠的也一定不要使用并行流,原本就只有两个线程,还搞休眠,等着整个服务崩溃咯。发布于 2022-10-14 10:30 •IP属地 甘肃举报评论收藏
 在漆黑的夜里,你需要一道光照亮夜行的路,我燃烧了我自己,但也造就了你我不能相拥。蚂蚱### 一、并行流的简单使用 ```java public static void main(String[] args) throws InterruptedException { //设置睡眠时间,方便visualVM监控到当前应用 Thread.sleep(25000); //groupingBy分组 键就是组名【返回值做组名】,Map的值就是该组的集合【满足条件的值】 Arrays.asList(1, 2, 3, 4, 5, 6, 7, 9, 8, 0, 1,1,2,3,4,5,9) .stream() .parallel() .collect(Collectors.groupingBy(x -> { //控制台查看当前线程 System.out.println(Thread.currentThread().getName()); try { //执行慢点,方便visualVM上查看线程 Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } int i = x % 10; return i; })) .forEach((x, y) -> System.out.println(x + ":" + y)); } ``` visualVM查看到的线程:发现并行流使用的是ForkJoin的线程池,猜测底层使用的是ForkJoin 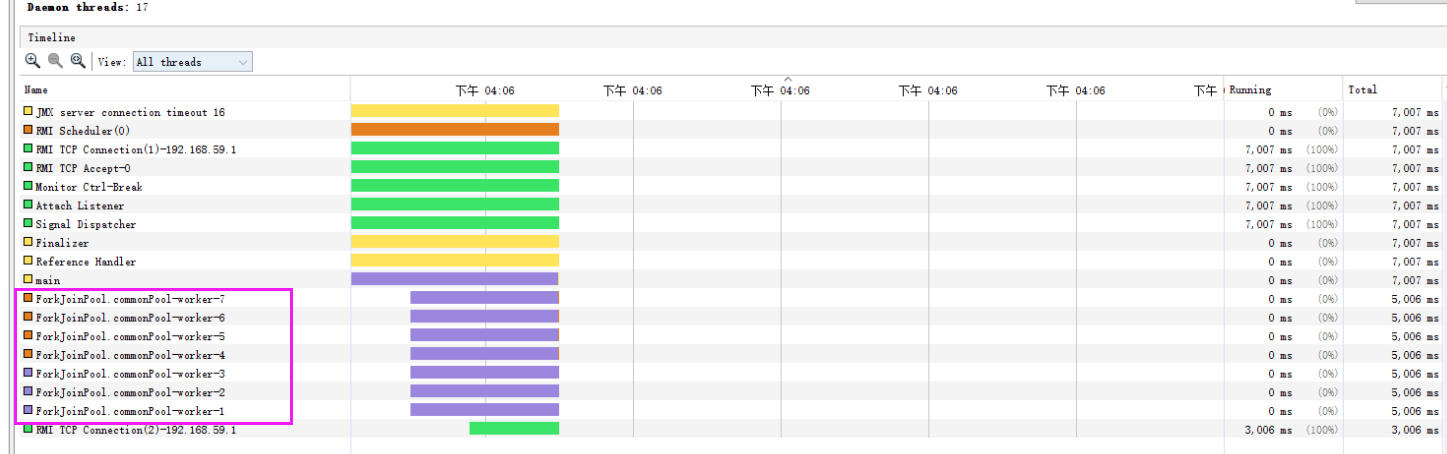 控制台:可以看到main线程也是参与了计算的过程 ```java main ForkJoinPool.commonPool-worker-5 ForkJoinPool.commonPool-worker-7 ForkJoinPool.commonPool-worker-3 ForkJoinPool.commonPool-worker-6 ForkJoinPool.commonPool-worker-7 ForkJoinPool.commonPool-worker-7 ForkJoinPool.commonPool-worker-1 ForkJoinPool.commonPool-worker-4 ForkJoinPool.commonPool-worker-2 ForkJoinPool.commonPool-worker-4 ForkJoinPool.commonPool-worker-1 ForkJoinPool.commonPool-worker-6 ForkJoinPool.commonPool-worker-7 ForkJoinPool.commonPool-worker-3 main ForkJoinPool.commonPool-worker-5 0:[0] 1:[1, 1, 1] 2:[2, 2] 3:[3, 3] 4:[4, 4] 5:[5, 5] 6:[6] 7:[7] 8:[8] 9:[9, 9] ``` ForkJoinPool如果没有向构造函数中传入希望的线程数量,那么当前计算机可用的CPU数量会被设置为线程数量作为默认值。 ### 1、我的CPU为8核,为啥只有七条线程? 由于 taskToFork.fork() 调用【这个后面源码解析,会说】,parallize使用了默认的ForkJoinPool.common 默认的一个静态线程池,这个线程池的默认线程个数是cpu 数量-1。 JDK8以后,ForkJoinPool又提供了一个静态方法commonPool(),这个方法返回一个ForkJoinPool内部声明的静态ForkJoinPool实例。 ```java //使用commonPool创建一个ForkJoin线程池 ForkJoinPool forkJoinPool = ForkJoinPool.commonPool(); ForkJoinPool类: public static ForkJoinPool commonPool() { // assert common != null : "static init error"; return common; } static { xxx省略 common = java.security.AccessController.doPrivileged (new java.security.PrivilegedAction<ForkJoinPool>() { public ForkJoinPool run() { return makeCommonPool(); }}); int par = common.config & SMASK; // report 1 even if threads disabled commonParallelism = par > 0 ? par : 1; } //可以看到线程数为Runtime.getRuntime().availableProcessors() - 1 //即cpu核数-1 private static ForkJoinPool makeCommonPool() { xxx省略 if (parallelism < 0 && // default 1 less than #cores (parallelism = Runtime.getRuntime().availableProcessors() - 1) <= 0) parallelism = 1; if (parallelism > MAX_CAP) parallelism = MAX_CAP; return new ForkJoinPool(parallelism, factory, handler, LIFO_QUEUE, "ForkJoinPool.commonPool-worker-"); } ``` ### 2、如何控制parallize的线程数? 1、启动参数指定-Djava.util.concurrent.ForkJoinPool.common.parallelism=3 2、代码指定System.setProperty("java.util.concurrent.ForkJoinPool.common.parallelism","3"); 3、可以自己构建一个ForkJoinPool,向其中提交一个parallize并行任务,可以做到控制并发度。例如: ```java public static void main(String[] args) throws InterruptedException, ExecutionException { ForkJoinPool pool = new ForkJoinPool(2); pool.execute(()->{ //groupingBy分组 键就是组名【返回值做组名】,Map的值就是该组的集合【满足条件的值】 Arrays.asList(1, 2, 3, 4, 5, 6, 7, 9, 8, 0, 1,1,2,3,4,5,9) .stream() .parallel() .collect(Collectors.groupingBy(x -> { System.out.println(Thread.currentThread().getName()); int i = x % 10; return i; })) .forEach((x, y) -> System.out.println(x + ":" + y)); }); Thread.sleep(2000); } ``` 注:一般不建议修改,因为修改虽然改进当前的业务逻辑,但对于整个项目中其它地方只是用来做非耗时的并行流运算,性能就不友好了,因为所有使用并行流parallerStream的地方都是使用同一个Fork-Join线程池,而Fork-Join线程数默认仅为cpu的核心数。最好是自己创建一个Fork-Join线程池来用,即方法3。 对于CPU密集型的任务,cpu的核数作为最大线程数,可以保持cpu的效率最高。因此,一般是不建议修改,修改也是使用第三种方式针对某个业务进行特定的修改就行,不要全局修改。 ### 二、源码解析 我们知道Stream是一个惰性求值的系统,那么我们只需要找它最后求值的过程,看它是怎样进行求值的就可以了。在AbstractPipeline这个类里面我们找到了Stream 计算的最终求值过程的默认实现: ``` final <R> R evaluate(TerminalOp<E_OUT, R> terminalOp) { assert getOutputShape() == terminalOp.inputShape(); if (linkedOrConsumed) throw new IllegalStateException(MSG_STREAM_LINKED); linkedOrConsumed = true; return isParallel() 8行 ? terminalOp.evaluateParallel(this, sourceSpliterator(terminalOp.getOpFlags())) : terminalOp.evaluateSequential(this, sourceSpliterator(terminalOp.getOpFlags())); } ``` 在8行,我们可以看到,在求值的时候会检查并行计算的标志位,如果标志了并行计算的话,我们就会并行求值,反之则会串行求值。我们可以进一步进入并行求值的逻辑中,这是一个TerminalOp的默认接口方法,默认实现就是直接调用串行求值,在FindOp、ForEachOp、MatchOp 和 ReduceOp中得到了覆盖。 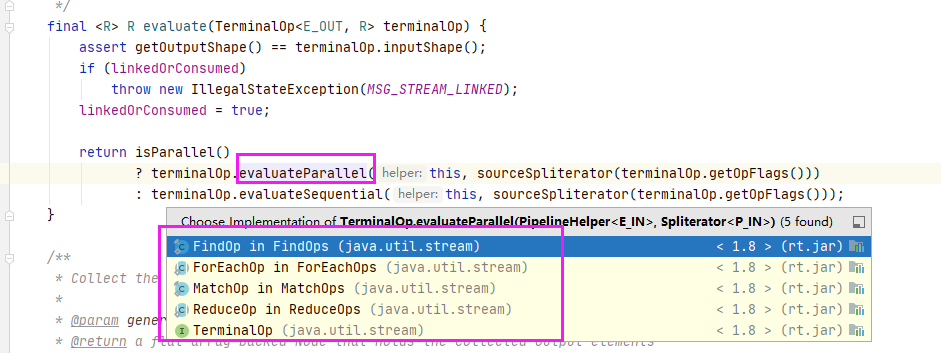 随便进一个:比如FindOp ```java @Override public <P_IN> O evaluateParallel(PipelineHelper<T> helper, Spliterator<P_IN> spliterator) { return new FindTask<>(this, helper, spliterator).invoke(); } ``` 发现FindOp底层是直接new了一个Task,ForEachOp、MatchOp、ReduceOp也都是创建一个Task,然后执行invoke方法。 看看这个Task是个什么玩意儿 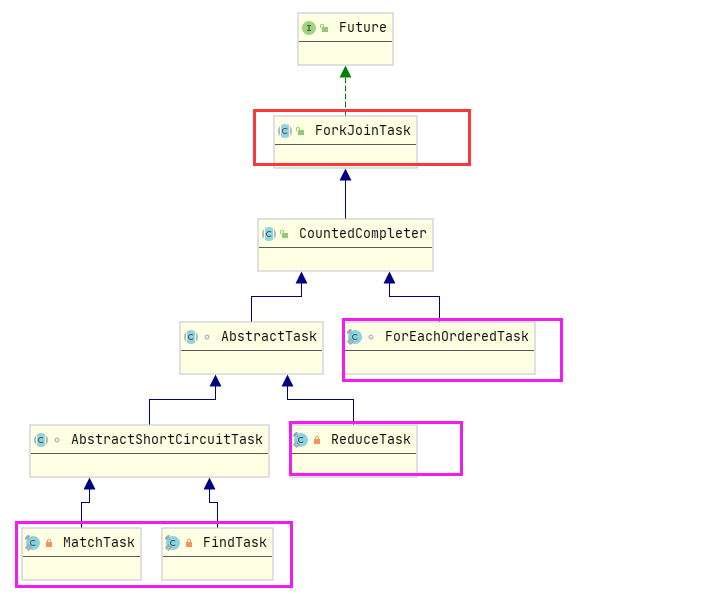 可以看出所有的Task 都继承自Jdk7 中引入的ForkJoin 并行框架的ForkJoinTask。所以我们可以看出Stream 的并行是依赖于ForkJoin 框架的。 ForkJoin进行计算任务时,计算类是要继承ForkJoinTask并且重写compute方法的。 以AbstractTask为例我们看看它是如何进行并行计算的: ``` @Override public void compute() { Spliterator<P_IN> rs = spliterator, ls; // right, left spliterators long sizeEstimate = rs.estimateSize(); long sizeThreshold = getTargetSize(sizeEstimate); boolean forkRight = false; @SuppressWarnings("unchecked") K task = (K) this; while (sizeEstimate > sizeThreshold && (ls = rs.trySplit()) != null) { K leftChild, rightChild, taskToFork; task.leftChild = leftChild = task.makeChild(ls); task.rightChild = rightChild = task.makeChild(rs); task.setPendingCount(1); if (forkRight) { forkRight = false; rs = ls; task = leftChild; taskToFork = rightChild; } else { forkRight = true; task = rightChild; taskToFork = leftChild; } taskToFork.fork(); sizeEstimate = rs.estimateSize(); } task.setLocalResult(task.doLeaf()); task.tryComplete(); } ReduceTask(ReduceTask<P_IN, P_OUT, R, S> parent, Spliterator spliterator) { super(parent, spliterator); this.op = parent.op; } @Override protected ReduceTask<P_IN, P_OUT, R, S> makeChild(Spliterator spliterator) { return new ReduceTask<>(this, spliterator); } ``` 这里面的主要逻辑就是: 先调用当前splititerator 方法的estimateSize 方法,预估这个分片中的数据量 1. 根据预估的数据量获取最小处理单元的大小阈值,即当数据量已经小于这个阈值的时候进行计算,否则进行fork 2. 将任务划分成更小的数据块,进行求解。这里值得注意的是,getTargetSize 在第一次调用的时候会设置: 3. 预测数据量大小 / (默认并发度 * 4) 的结果作为最小执行单元的数量(配置的默认值是cpu 数 – 4. 1,可以通过java.util.concurrent.ForkJoinPool.common.parallelism设置) 5. 如果当前分片大小仍然大于处理数据单元的阈值,且分片继续尝试切分成功,那么就继续切分,分别将左右分片的任务创建为新的Task,并且将当前的任务关联为两个新任务的父级任务(逻辑在makeChild 6. 里面) 7. 先后对左右子节点的任务进行fork,对另外的分区进行分解。同时设定pending 为1,这代表一个task 8. 实际上只会有一个等待的子节点(被fork)。 9. 当任务已经分解到足够小的时候退出循环,尝试进行结束。调用子类实现的doLeaf方法,完成最小计算单元的计算任务,并设置到当前任务的localResult中 10. 调用tryComplete 方法进行最终任务的扫尾工作,如果该任务pending 11. 值不等于0,则原子的减1,如果已经等于0,说明任务都已经完成,则调用onCompletion 12. 回调,如果该任务是叶子任务,则直接销毁中间数据结束;如果是中间节点会将左右子节点的结果进行合并 13. 检查如果这个任务已经没有父级任务了,则将该任务置为正常结束,如果还有则尝试递归的去调用父级节点的onCompletion回调,逐级进行任务的合并。 ### 回到问题我的CPU为8核,为啥只有七条线程? taskToFork.fork()的调用就是在compute这里被调用,common就是一个静态的线程池 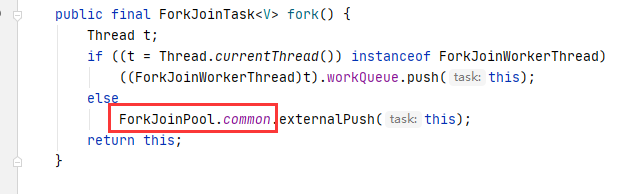发布于 2022-03-10 17:33 •IP属地 安徽举报评论收藏
公众号进入网站体验更佳
