
聚集索引是什么?聚集索引的优点是啥?聚集索引的缺点是啥?
1 个回答
 重新审视自己,什么使你快乐,什么就是眼下最珍贵。东方朔聚集索引与非聚集索引的最主要的区别是:叶节点是否存放一整行记录 ### innodb的聚集索引 innodb的索引是聚集索引,就是所有数据都存在聚集索引的的叶子节点中,其他二级索引的的叶子节点值存储KEY字段加对应列的主键值,如果使用二级索引查找数据,先根据索引查到二级索引对应的行的主键id,然后根据主键id去聚集索引中查找对应的行的数据。(所以innodb必须要有主键)。 聚集索引示意图一: 聚集索引是依据B+树来实现的,索引节点(也就是非叶子节点)只存储索引值,叶子节点才会存具体的数据行,每个索引节点都是一个内存页(由于只存索引值,相比B树,B+树的每个索引节点的内存页可以存储更多的索引值),每个叶子节点也都是一个内存页,内存页里面数据行按主键id从小到大的顺序存储,然后叶子节点之间是通过指针连接的,形成一个双向链表。所以聚集索引的叶子节点在逻辑上是存储在一起的,在物理上是并不是连续的,而是通过双向链表连接的。假设说叶子节点在物理上的存储也是连续,那么如果中间的叶子节点中大量插入数据行,导致叶子节点的内存页容量不够时,需要后面的叶子节点全部后移,这样维护成本会很高。如果叶子节点只是通过双向链表进行连接,当中间的叶子节点容量不够时,可以新增一个内存页,插入在其中,作为一个叶子节点,只需要修改双向链表中的指针即可。 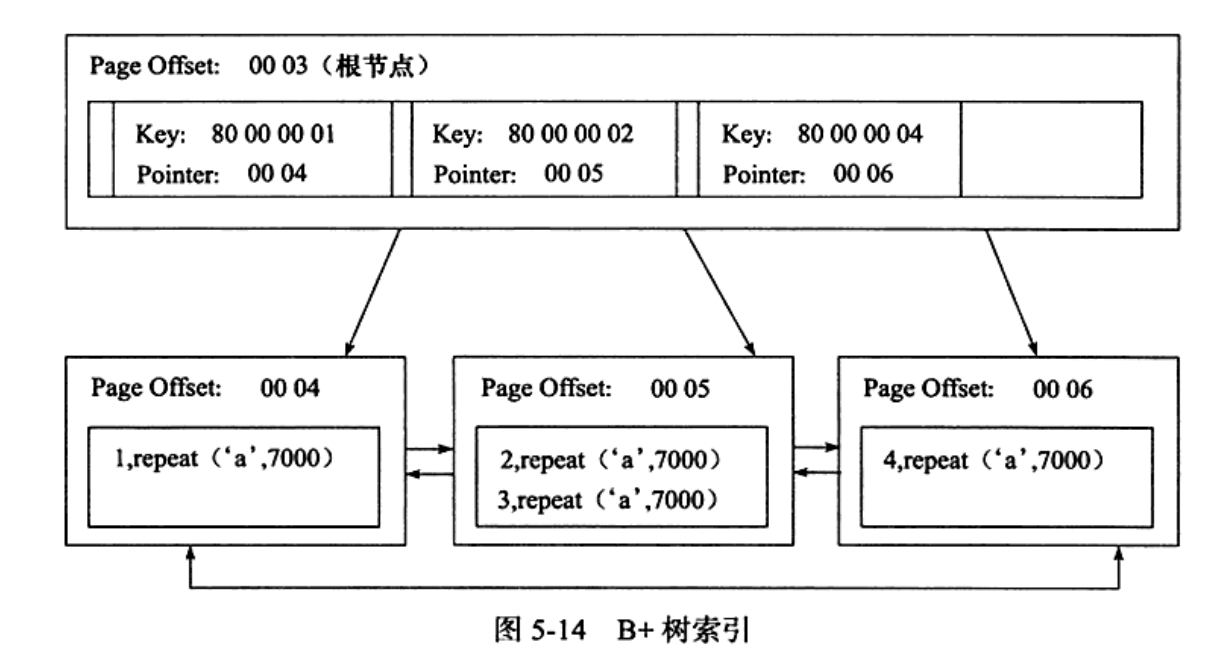 聚集索引示意图二: 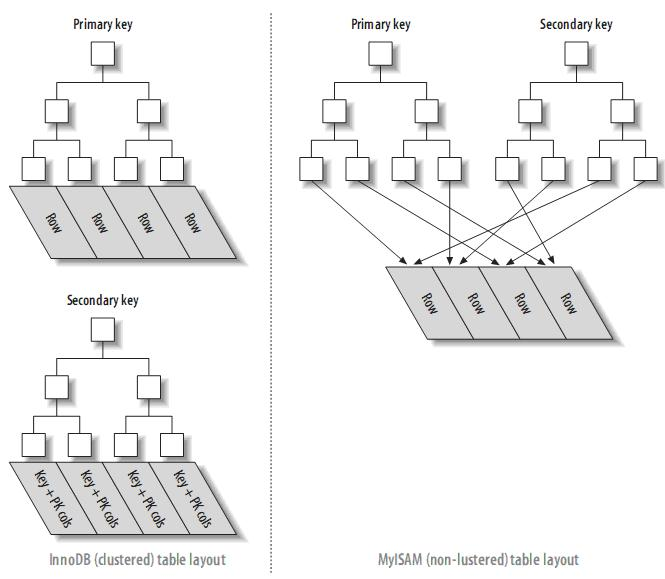 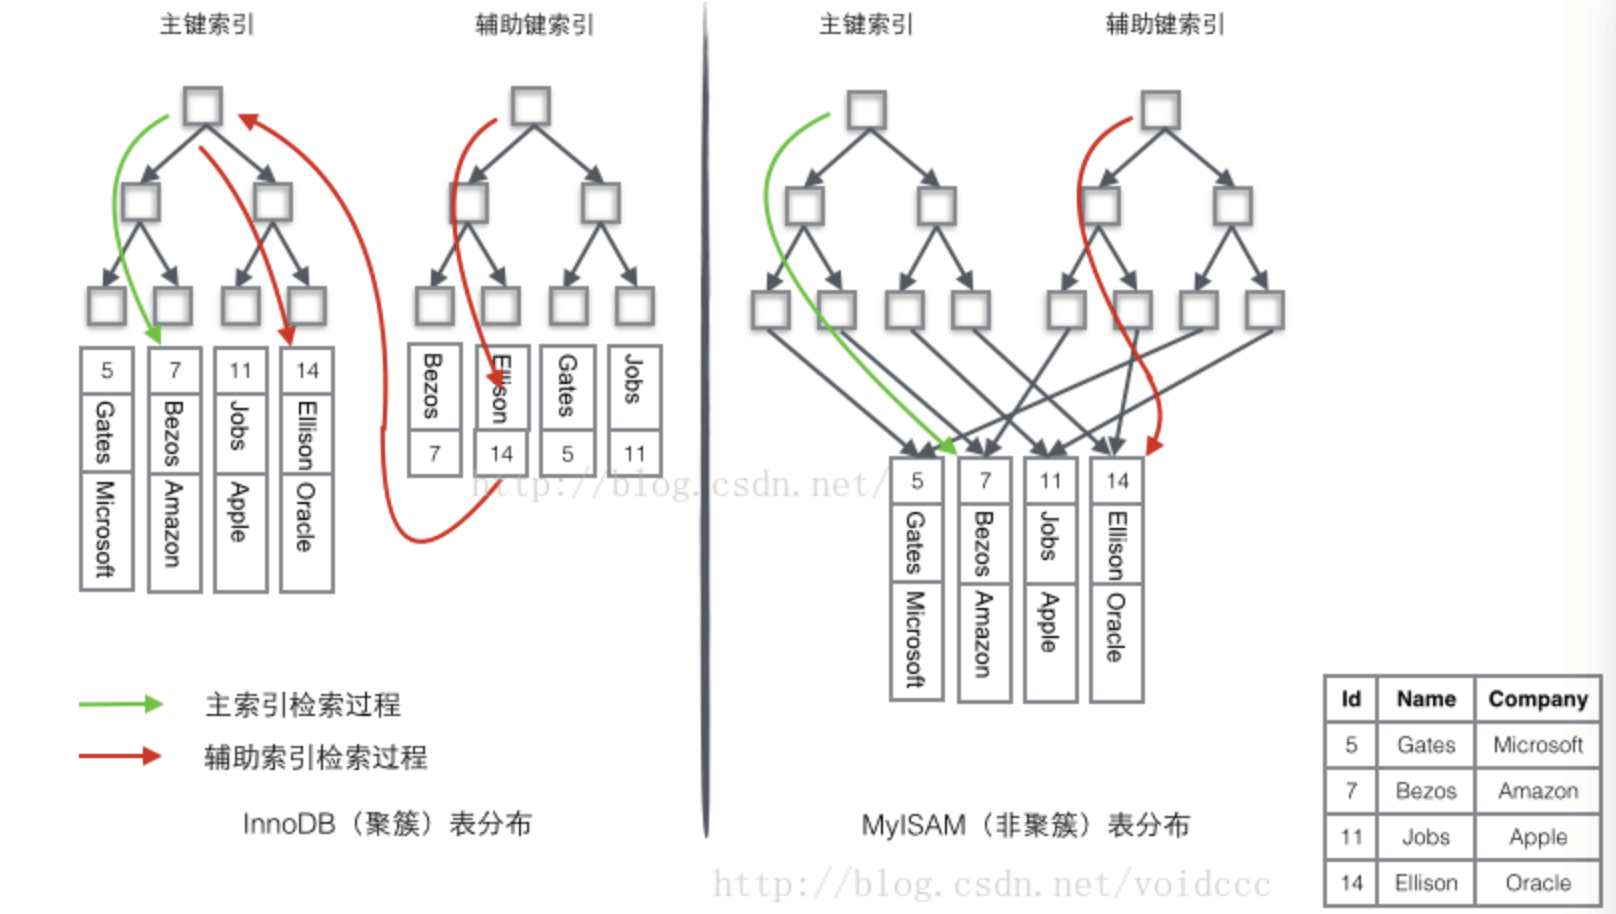 1.对于聚集索引表来说(左图),表数据是和主键一起存储的,主键索引的叶结点存储行数据(包含了主键值),其他列,事务ID,回滚指针,二级索引的叶结点存储行的主键值。使用的是B+树作为索引的存储结构,非叶子节点都是索引关键字,但非叶子节点中的关键字中不存储对应记录的具体内容或内容地址。叶子节点上的数据是主键与具体记录(数据内容)。 2.对于MyISAM的非聚集索引表来说(右图),表数据和索引是分成两部分存储的,主键索引和二级索引存储上没有任何区别。使用的是B+树作为索引的存储结构,所有的节点都是索引,叶子节点存储的是索引+指向索引对应的记录的数据的指针。 ### 聚集索引的优点 1.当你需要取出一定范围内的数据时,用聚集索引也比用非聚集索引好。 2.当通过聚集索引查找目标数据时理论上比非聚集索引要快,因为非聚集索引定位到对应主键时还要多一次目标记录寻址,即多一次I/O。 3.使用覆盖索引扫描的查询可以直接使用页节点中的主键值。 ### 聚集索引的缺点 1.随机插入容易造成页分裂,按照主键的顺序插入是最快的方式,否则将会出现页分裂(就是存储数据行的内存页容量不够,需要新申请一个内存页分担一部分数据行),影响性能。因此,对于InnoDB表,我们一般都会定义一个自增的ID列为主键。 2.更新主键的代价很高,因为将会导致被更新的行移动。因此,对于InnoDB表,我们一般定义主键为不可更新。 3.二级索引访问需要两次索引查找,第一次找到主键值,第二次根据主键值找到行数据。 二级索引的叶节点存储的是主键值,而不是行指针(非聚集索引存储的是指针或者说是地址),这是为了减少当出现行移动或数据页分裂时二级索引的维护工作,但会让二级索引占用更多的空间。 4.采用聚集索引插入新值比采用非聚集索引插入新值的速度要慢很多,因为插入要保证主键不能重复,判断主键不能重复,采用的方式在不同的索引下面会有很大的性能差距,聚集索引遍历所有的叶子节点,非聚集索引也判断所有的叶子节点,但是聚集索引的叶子节点除了带有主键还有记录值,记录的大小往往比主键要大的多。这样就会导致聚集索引在判定新记录携带的主键是否重复时进行昂贵的I/O代价。发布于 2022-02-08 21:58 •IP属地 湖北举报评论收藏
公众号进入网站体验更佳
