
mysql join查询的数据太多了,不会把内存撑满吗?join查询的流程是什么?
1 个回答
 希望有人告诉你开心比对错更重要。梅拾璎join_buffer 的大小是由参数 join_buffer_size 设定的,默认值是 256k。如果放不下表 t1 的所有数据话,策略很简单,就是分段放。我把 join_buffer_size 改成 1200,再执行: ``` select * from t1 straight_join t2 on (t1.a=t2.b); ``` 执行过程就变成了: 1. 扫描表 t1,顺序读取数据行放入 join_buffer 中,放完第 88 行 join_buffer 满了,继续第 2 步; 2. 扫描表 t2,把 t2 中的每一行取出来,跟 join_buffer 中的数据做对比,满足 join 条件的,作为结果集的一部分返回; 3. 清空 join_buffer; 4. 继续扫描表 t1,顺序读取最后的 12 行数据放入 join_buffer 中,继续执行第 2 步。执行流程图也就变成这样: 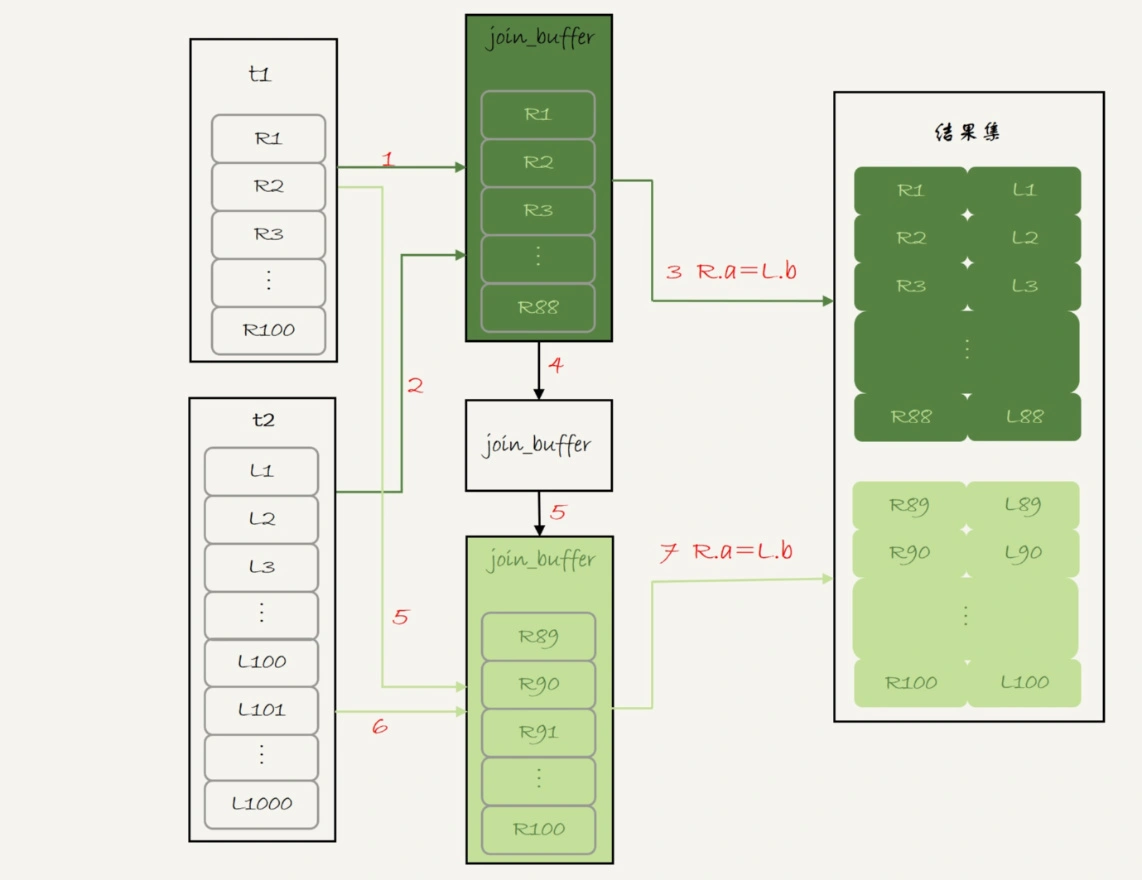 这个流程才体现出了这个算法名字中“Block”的由来,表示“分块去 join”。可以看到,这时候由于表 t1 被分成了两次放入 join_buffer 中,导致表 t2 会被扫描两次。虽然分成两次放入 join_buffer,但是判断等值条件的次数还是不变的,依然是 (88+12)*1000=10 万次。发布于 2022-02-26 03:23 •IP属地 重庆举报评论收藏1
公众号进入网站体验更佳
