
怎么如何优化Join速度?
1 个回答
 二八佳人体似酥,腰间仗剑斩凡夫。小菜鸟### 1.用小结果集驱动大结果集,减少外层循环的数据量 如果小结果集和大结果集连接的列都是索引列,mysql在内连接时也会选择用小结果集驱动大结果集,因为索引查询的成本是比较固定的,这时候外层的循环越少,join的速度便越快。 为匹配的条件增加索引:争取使用Index Nested-Loop Join,减少内层表的循环次数 ### 2.增大join buffer size的大小: 当使用BNLJ时,一次缓存的数据越多,那么外层表循环的次数就越少。 可能会导致 Buffer Pool 的热数据被淘汰,影响内存命中率。大表 join 操作虽然对 IO 有影响,但是在语句执行结束后,对 IO 的影响也就结束了。但是,对 Buffer Pool 的影响就是持续性的,需要依靠后续的查询请求慢慢恢复内存命中率。 ### 3.减少不必要的字段查询: (1)当用到BNLJ时,字段越少,join buffer 所缓存的数据就越多,外层表的循环次数就越少; (2)当用到INLJ时,如果可以不回表查询,即利用到覆盖索引,则可能可以提示速度。(未经验证,只是一个推论) ### 4.排序时尽量使用驱动表中的字段 因为如果使用的是非驱动表中的字段会对非驱动表(的字段排序)需要对循环查询的合并结果(临时表)进行排序,比较耗时,使用Explain时会发现出现Using temporary。 ### 5.使用临时表做查询优化。(适合低频的sql,不值得建立索引) 如 t1=1000行 t2 100w行,但是where过滤之后t2还有2000。虽然t2要扫描100万行,但是比较次数是1000*100 万 =10 亿次. 这个就比较慢了, ``` select * from t1 join t2 on (t1.b=t2.b) where t2.b>=1 and t2.b<=2000; ```  可以通过临时表 ``` create temporary table temp_t(id int primary key, a int, b int, index(b))engine=innodb; insert into temp_t select * from t2 where b>=1 and b<=2000; select * from t1 join temp_t on (t1.b=temp_t.b); ``` 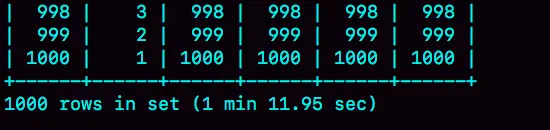 可以看到,整个过程 3 个语句执行时间的总和还不到 1 秒,相比于前面的 1 分 11 秒,性能得到了大幅提升。 ### 6.考虑回表问题,打开批量回表配置,其实是range 范围查询 如果你想要稳定地使用 MRR 优化的话,需要设置set optimizer_switch="mrr_cost_based=off"。(官方文档的说法,是现在的优化器策略,判断消耗的时候,会更倾向于不使用 MRR,把 mrr_cost_based 设置为 off,就是固定使用 MRR 了。) mysql在join的时候有2个算法 Index Nested-Loop Join(NLJ 索引嵌套循环连接) 和 Block Nested-Loop Join(BNL 缓存块嵌套循环连接)。 参考文档 [https://www.wengbi.com/thread_99558_1.html](https://www.wengbi.com/thread_99558_1.html) [https://www.cnblogs.com/starhu/p/6418842.html](https://www.cnblogs.com/starhu/p/6418842.html) [https://www.cnblogs.com/starhu/p/6418833.html](https://www.cnblogs.com/starhu/p/6418833.html)编辑于 2022-03-05 16:43 •IP属地 辽宁举报评论收藏
公众号进入网站体验更佳
