
B树与B+树的区别是什么?
2 个回答
 二八佳人体似酥,腰间仗剑斩凡夫。小菜鸟B+树是为磁盘存储专门设计的一M阶多路平衡查找树(阶数可以理解为每个节点最多的孩子节点的个数,二叉树就是2阶),所有记录节点都是按照从小到大顺序存放在最后一层的叶子节点上,由各叶子节点的指针相连接。可以认为一个叶子节点就是一个内存页(默认情况下,一个内存页大小为16K),每个内存页里面存储多个数据行,内存页直接通过指针连接,形成一个双向链表,所以叶子节点在逻辑上是连续的,在物理上不是连续存储的,就是每个叶子节点可以存储在不同地址上,通过指针相互连接。每个非叶子节点(也就是索引节点)也是一个内存页,里面存储了很多索引节点的值,但是B+树索引节点只存索引值,不存数据行的数据,这样可以让每个索引内存页存储更多的索引值,这样可以使得B+树的层数更少(这也是B+树比B树更优的地方)。B+树在数据库的中实现一般是只有2到4层,机械磁盘一般1秒可以进行100次IO,也意味着每次在B+树中的查询操作可以在20ms到40ms之间完成。 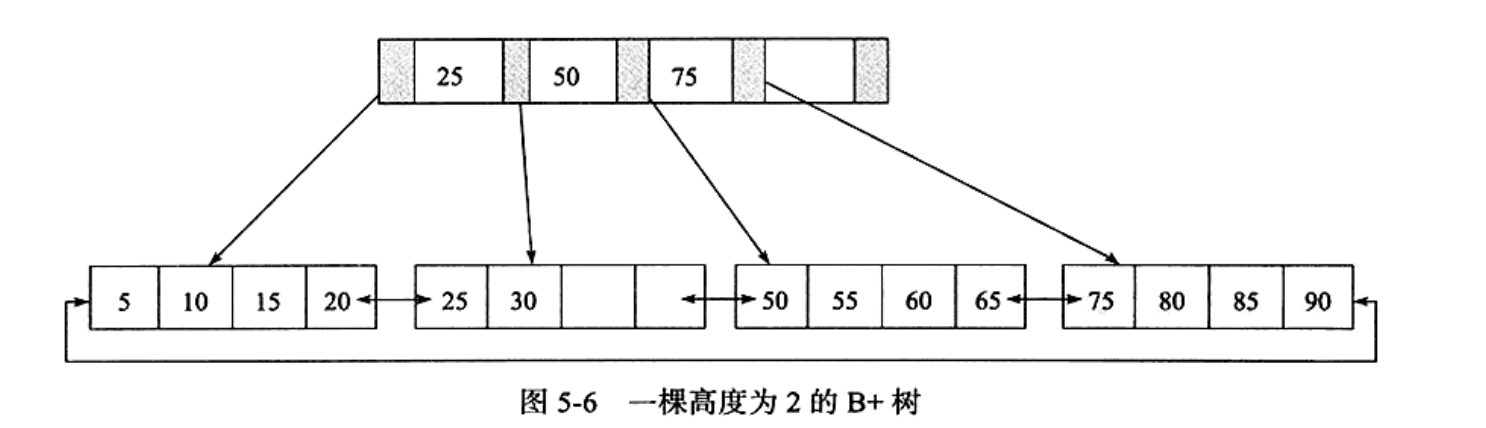 1.B树每个节点会保存关键字,索引和数据。而B+树只有叶子节点保存数据,其他节点只保存关键字和索引。所以相同的内存空间可以容纳更多的索引节点。 2.B+树的所有数据都存在叶子节点上,所以查询会更加稳定,而且相邻的叶子节点都是连接在一起的,更加适合区间查找和搜索。发布于 2022-02-04 14:45 •IP属地 辽宁举报评论收藏
 用眼睛是看不到事物的本质的,只有心灵才能够洞察一切。hello平衡二叉树的查找效率是非常高的,并可以通过降低树的深度来提高查找的效率。但是当数据量非常大,树的存储的元素数量是有限的,这样会导致二叉查找树结构由于树的深度过大而造成磁盘 I/O 读写过于频繁,进而导致查询效率低下。 而 B 树的出现是为了解决这个问题,其可以一次性读入许多数据。一个节点不再只是存储一个数值,而是存储一个分片的数据。这样就可以避免频繁去读取磁盘数据,造成频繁的 IO 访问,造成查找速度瓶颈。 ### B树 B-Tree 其实就是 B 树,很多人都会说成 B 减树,其实是错的,要注意。 B 树不要和二叉树混淆,B 树不是二叉树,而是一种自平衡树数据结构。 它维护有序数据并允许以对数时间进行搜索,顺序访问,插入和删除。B 树是二叉搜索树的一般化,因为 B 树的节点可以有两个以上的子节点。 与其他自平衡二进制搜索树不同,B 树非常适合读取和写入相对较大的数据块(如光盘)的存储系统。它通常用于数据库和文件系统,例如 mysql 的 InnoDB 引擎使用的数据结构就是 B 树的变形 B+ 树。 B 树是一种平衡的多分树,通常我们说 m 阶的 B 树,它必须满足如下条件: 1. 每个节点最多只有 m 个子节点。 2. 每个非叶子节点(除了根)具有至少 ⌈m/2⌉ 子节点。 3. 如果根不是叶节点,则根至少有两个子节点。 4. 具有 k 个子节点的非叶节点包含 k -1 个键。 5. 所有叶子都出现在同一水平,没有任何信息(高度一致)。 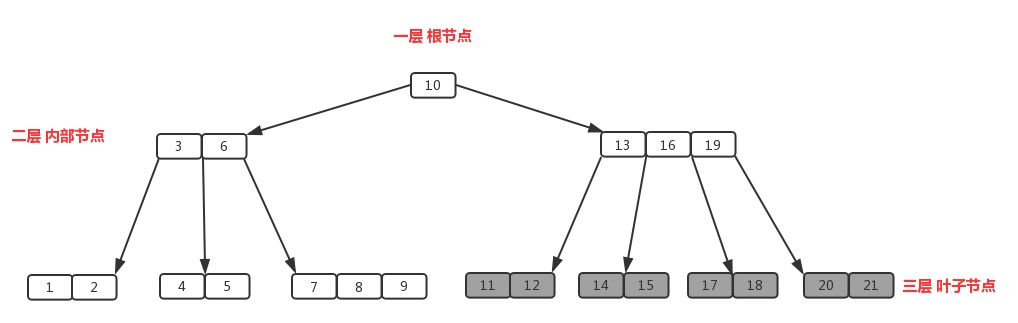 B 树的阶,指的是 B 树中节点的子节点数目的最大值。例如在上图的书中,「13,16,19」拥有的子节点数目最多,一共有四个子节点(灰色节点)。所以该 B 树的阶为 4,该树称为 4 阶 B 树。在实际应用中,B 树应用于 MongoDb 的索引。 ### B+树 B+ 树是应文件系统所需而产生的 B 树的变形树。B+ 树的特征: 1. 有 m 个子树的中间节点包含有 m 个元素(B 树中是 k-1 个元素),每个元素不保存数据,只用来索引。 2. 所有的叶子结点中包含了全部关键字的信息,及指向含有这些关键字记录的指针,且叶子结点本身依关键字的大小自小而大的顺序链接。而 B 树的叶子节点并没有包括全部需要查找的信息。 3. 所有的非终端结点可以看成是索引部分,结点中仅含有其子树根结点中最大(或最小)关键字。而 B 树的非终节点也包含需要查找的有效信息。例如下图中的根节点 8 是左子树中最大的元素,15 是右子树中最大的元素。 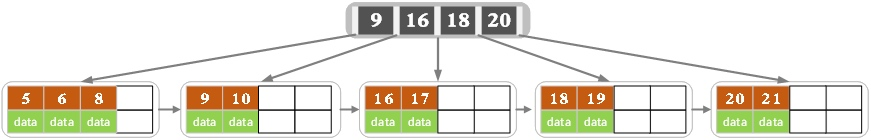 与 B 树相比,B+ 树有着如下的好处: #### 1.B+ 树的磁盘读写代价更低 B+ 树的内部结点并没有指向关键字具体信息的指针,所以其内部结点相对 B 树更小。如果把所有同一内部结点的关键字存放在同一盘块中,那么盘块所能容纳的关键字数量也越多,所以一次性读入内存中的需要查找的关键字也就越多。相对来说 IO 读写次数也就降低了,查找速度就更快了。 #### 2.B+ 树查询效率更加稳定 由于非终结点并不是最终指向文件内容的结点,而只是叶子结点中关键字的索引。所以 B+ 树中任何关键字的查找必须走一条从根结点到叶子结点的路。所有关键字查询的路径长度相同,导致每一个数据的查询效率相当。而对于 B 树来说,因为其每个节点都存具体的数据,因此其查询速度可能更快,但是却并不稳定。 #### 3.B+ 树便于范围查询(最重要的原因,范围查找是数据库的常态) B 树在提高了 IO 性能的同时,并没有解决元素遍历效率低下的问题。为了解决这个问题,B+ 树应用而生。B+ 树只需要去遍历叶子节点就可以实现整棵树的遍历。在数据库中基于范围的查询是非常频繁的,因此 MySQL 的 Innodb 引擎就使用了 B+ 树作为其索引的数据结构。 ### 总结 B 树是为了解决大数据量的查找问题而诞生的,其实二叉搜索树的一般化。通过每个节点存储更多的数据,使得 B 树比起二叉搜索树更加扁平化,从而减少 IO 读取频次,提高搜索速度。 B+ 树比起 B 树,最大的差异是非叶子节点不再存储具体数据,以及叶子节点是链表结构。非叶子节点不再存储具体数据,这使得 B+ 树更加扁平化,查找效率更高。叶子节点是链表结构,这使得 B+ 树更适合用在范围查找的场景中。发布于 2022-01-31 22:08 •IP属地 甘肃举报评论收藏
公众号进入网站体验更佳
