
dubbo是长连接还是短连接?
1 个回答
 为了击碎你伪装的表面,我只能用尽全身力气挥出那惊鸿的半月弧光。云说在 Java 中,使用 TCP 通信,大概率会涉及到 Socket、Netty,本文会借用它们的一些 API 和设置参数来辅助介绍。 ### 长连接与短连接 TCP 本身并没有长短连接的区别,长短与否,完全取决于我们怎么用它。 > 短连接:每次通信时,创建 Socket;一次通信结束,调用 socket.close()。这就是一般意义上的短连接,短连接的好处是管理起来比较简单,存在的连接都是可用的连接,不需要额外的控制手段。 长连接:每次通信完毕后,不会关闭连接,这样就可以做到连接的复用。长连接的好处便是省去了创建连接的耗时。 短连接和长连接的优势,分别是对方的劣势。想要图简单,不追求高性能,使用短连接合适,这样我们就不需要操心连接状态的管理;想要追求性能,使用长连接,我们就需要担心各种问题:比如端对端连接的维护,连接的保活。 长连接还常常被用来做数据的推送,我们大多数时候对通信的认知还是 request/response 模型,但 TCP 双工通信的性质决定了它还可以被用来做双向通信。在长连接之下,可以很方便的实现 push 模型。 短连接没有太多东西可以讲,所以下文我们将目光聚焦在长连接的一些问题上。纯讲理论未免有些过于单调,所以下文我借助 Dubbo 这个 RPC 框架的一些实践来展开 TCP 的相关讨论。 ### 服务治理框架中的长连接 前面已经提到过,追求性能的时候,必然会选择使用长连接,所以借助 Dubbo 可以很好的来理解 TCP。我们开启两个 Dubbo 应用,一个 server 负责监听本地 20880(众所周知,这是 Dubbo 协议默认的端口),一个 client 负责循环发送请求。执行lsof -i:20880命令可以查看端口的相关使用情况: 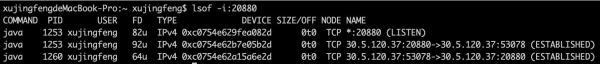 1. *:20880 (LISTEN)说明了 Dubbo 正在监听本地的 20880 端口,处理发送到本地 20880 端口的请求 2. 后两条信息说明请求的发送情况,验证了 TCP 是一个双向的通信过程,由于我是在同一个机器开启了两个 Dubbo 应用,所以你能够看到是本地的 53078 端口与 20880 端口在通信。我们并没有手动设置 53078 这个客户端端口,它是随机的,但也阐释了一个道理:即使是发送请求的一方,也需要占用一个端口。 3. 稍微说一下 FD 这个参数,他代表了文件句柄,每新增一条连接都会占用新的文件句柄,如果你在使用 TCP 通信的过程中出现了open too many files的异常,那就应该检查一下,你是不是创建了太多的连接,而没有关闭。细心的读者也会联想到长连接的另一个好处,那就是会占用较少的文件句柄。 长连接的维护 因为客户端请求的服务可能分布在多个服务器上,客户端端自然需要跟对端创建多条长连接,使用长连接,我们遇到的第一个问题就是要如何维护长连接。 ```java @Sharable public class NettyHandler extends SimpleChannelHandler { private final Map<String, Channel> channels = new ConcurrentHashMap<String, Channel>(); // <ip:port, channel> } public class NettyServer extends AbstractServer implements Server { private Map<String, Channel> channels; // <ip:port, channel> } ``` 在 Dubbo 中,客户端和服务端都使用ip:port维护了端对端的长连接,Channel 便是对连接的抽象。我们主要关注 NettyHandler 中的长连接,服务端同时维护一个长连接的集合是 Dubbo 的设计,我们将在后面提到。 连接的保活 这个话题就有的聊了,会牵扯到比较多的知识点。首先需要明确一点,为什么需要连接的报活?当双方已经建立了连接,但因为网络问题,链路不通,这样长连接就不能使用了。需要明确的一点是,通过 netstat,lsof 等指令查看到连接的状态处于ESTABLISHED状态并不是一件非常靠谱的事,因为连接可能已死,但没有被系统感知到,更不用提假死这种疑难杂症了。如果保证长连接可用是一件技术活。 连接的保活:KeepAlive 首先想到的是 TCP 中的 KeepAlive 机制。KeepAlive 并不是 TCP 协议的一部分,但是大多数操作系统都实现了这个机制。KeepAlive 机制开启后,在一定时间内(一般时间为 7200s,参数tcp_keepalive_time)在链路上没有数据传送的情况下,TCP 层将发送相应的KeepAlive探针以确定连接可用性,探测失败后重试 10(参数tcp_keepalive_probes)次,每次间隔时间 75s(参数tcp_keepalive_intvl),所有探测失败后,才认为当前连接已经不可用。 在 Netty 中开启 KeepAlive: bootstrap.option(ChannelOption.SO_KEEPALIVE, true) Linux 操作系统中设置 KeepAlive 相关参数,修改/etc/sysctl.conf文件: ```java net.ipv4.tcp_keepalive_time=90 net.ipv4.tcp_keepalive_intvl=15 net.ipv4.tcp_keepalive_probes=2 ``` KeepAlive 机制是在网络层面保证了连接的可用性,但站在应用框架层面我们认为这还不够。主要体现在两个方面: 1. KeepAlive 的开关是在应用层开启的,但是具体参数(如重试测试,重试间隔时间)的设置却是操作系统级别的,位于操作系统的/etc/sysctl.conf配置中,这对于应用来说不够灵活。 2. KeepAlive 的保活机制只在链路空闲的情况下才会起到作用,假如此时有数据发送,且物理链路已经不通,操作系统这边的链路状态还是 ESTABLISHED,这时会发生什么?自然会走 TCP 重传机制,要知道默认的 TCP 超时重传,指数退避算法也是一个相当长的过程。 3. KeepAlive 本身是面向网络的,并不是面向于应用的,当连接不可用时,可能是由于应用本身 GC 问题,系统 load 高等情况,但网络仍然是通的,此时,应用已经失去了活性,所以连接自然应该认为是不可用的。发布于 2022-03-22 06:27 •IP属地 天津举报评论收藏
公众号进入网站体验更佳
