
谈一谈你对LinkedHashMap的理解?
2 个回答
 看山,看水,看众生,也看自己。南宫博LinkedHashMap是HashMap的子类,与HashMap的实现基本一致,只是说在HashMap的基础上做了一些扩展,所有的节点都有一个before指针和after指针,根据插入顺序形成一个双向链表。默认accessOrder是false,也就是按照插入顺序来排序的,每次新插入的元素都是插入到链表的末尾。map.keySet().iterator().next()第一个元素是最早插入的元素的key。LinkedHashMap可以用来实现LRU算法。(accessOrder为true,会按照访问顺序来排序。) 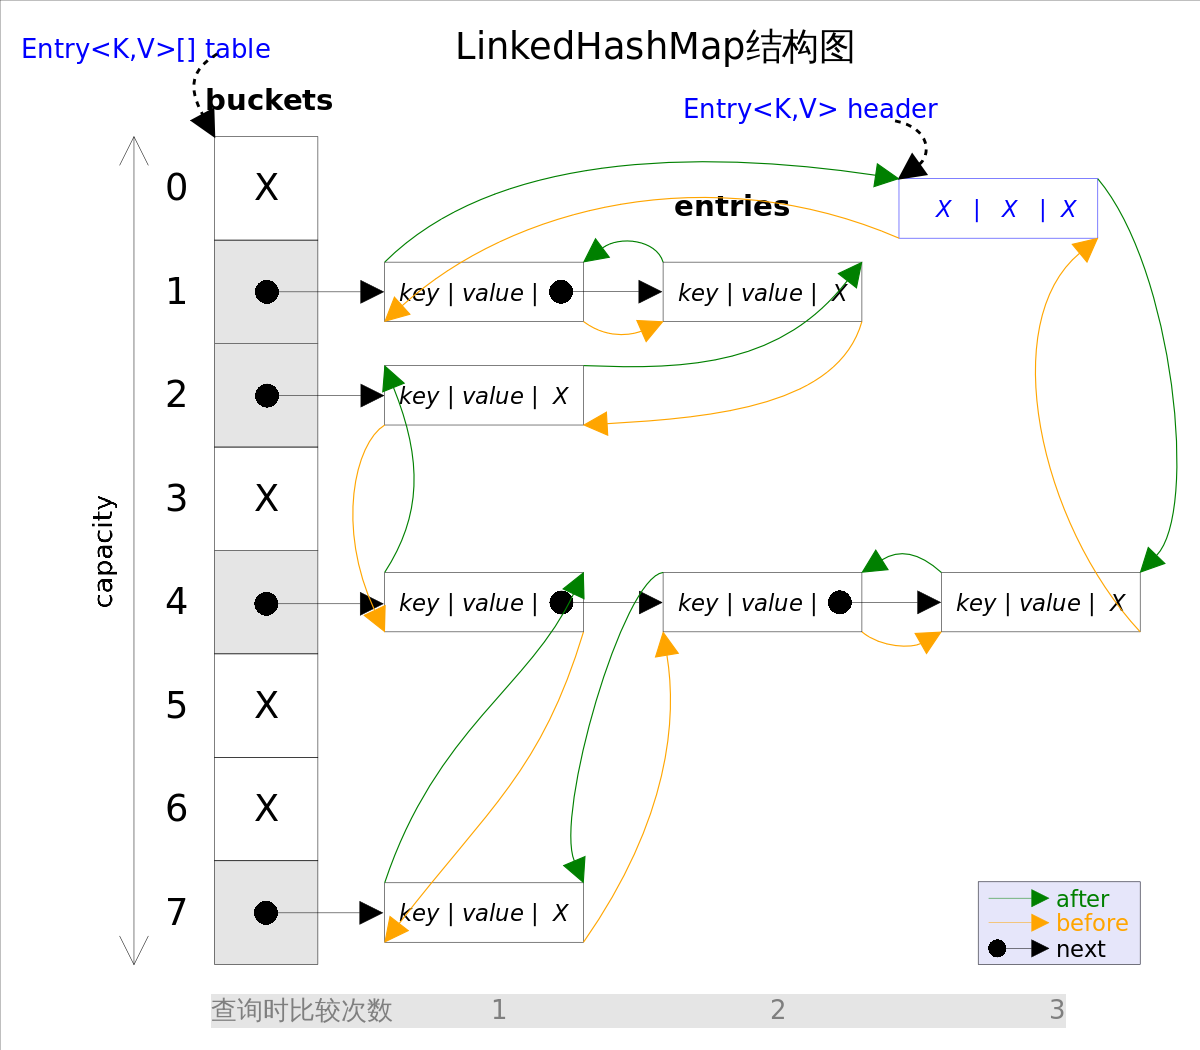 LRU算法实现: ```java //使用LinkedHashMap实现LRU算法(accessOrder为false的实现方式) // LinkedHashMap默认的accessOrder为false,也就是会按照插入顺序排序, // 所以在插入新的键值对时,总是添加在队列尾部, // 如果是访问已存在的键值对,或者是put操作的键值对已存在,那么需要将键值对先移除再添加。 public class LRUCache{ int capacity; Map<Integer, Integer> map; public LRUCache(int capacity) { this.capacity = capacity; map = new LinkedHashMap<>(); } public int get(int key) { if (!map.containsKey(key)) { return -1; } //先删除旧的位置,再放入新位置 Integer value = map.remove(key); map.put(key, value); return value; } public void put(int key, int value) { if (map.containsKey(key)) { map.remove(key); map.put(key, value); return; } //超出capacity,删除最久没用的,利用迭代器,删除第一个 if (map.size() > capacity) { map.remove(map.keySet().iterator().next()); } map.put(key, value); } } ``` 下面是另外一种实现方法: ```java //使用LinkedHashMap实现LRU算法(accessOrder为true的实现方式) //如果是将accessOrder设置为true,get和put已有键值对时就不需要删除key了 public static class LRUCache2 { int capacity; LinkedHashMap<Integer, Integer> linkedHashMap; LRUCache2(int capacity) { this.capacity = capacity; linkedHashMap = new LinkedHashMap<Integer, Integer>(16,0.75f,true); } public int get(int key) { Integer value = linkedHashMap.get(key); return value == null ? -1 : value; } public void put(int key, int val) { Integer value = linkedHashMap.get(key); linkedHashMap.put(key, val); if (linkedHashMap.size() > capacity) { linkedHashMap.remove(linkedHashMap.keySet().iterator().next()); } } } ```发布于 2024-11-10 19:09 •IP属地 青海举报评论收藏
 热爱漫无边际,生活自有分寸。亚林`LinkedHashMap` 是 Java 中的一个 `Map` 实现类,既具备 `HashMap` 的快速查找特性,也能够保持元素的顺序(插入顺序或访问顺序)。以下是对 `LinkedHashMap` 的理解: ### 1. `LinkedHashMap` 的特点 - **去重特性**:`LinkedHashMap` 和 `HashMap` 一样,通过 `hashCode()` 和 `equals()` 方法来判断键的唯一性,不允许重复键。 - **有序性**:`LinkedHashMap` 维护元素的顺序,可以按插入顺序或访问顺序(基于 LRU 机制)遍历。 - **基于双向链表实现顺序维护**:通过内部的双向链表维护顺序,每次插入新元素时都会将该元素添加到链表的末尾;如果开启了访问顺序模式,最近访问的元素会被移动到链表末尾。 ### 2. `LinkedHashMap` 的实现原理 `LinkedHashMap` 继承了 `HashMap`,并在其基础上增加了双向链表以保持顺序。主要的数据结构为 `LinkedHashMap.Entry` 类,它在 `HashMap.Node` 基础上增加了 `before` 和 `after` 指针,分别指向前后节点,从而形成一个双向链表。 #### 关键实现细节 - **插入顺序维护**:在 `put` 方法中,通过 `linkNodeLast` 方法将新节点添加到双向链表的末尾,使得遍历时按照插入顺序输出。 - **访问顺序维护(可选)**:通过构造器的 `accessOrder` 参数控制是否按访问顺序进行排序。当 `accessOrder` 为 `true` 时,每次访问一个元素(如通过 `get` 方法)后,该元素会被移动到链表末尾,形成 LRU 顺序。 ```java public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } ``` - **双向链表节点结构**: 每个节点既在哈希表中用于快速查找,也在双向链表中连接,实现顺序遍历。通过 `before` 和 `after` 指针连接所有节点形成链表。 ### 3. `LinkedHashMap` 的使用场景 - **缓存系统**:`LinkedHashMap` 的 LRU 模式非常适合实现简单的缓存淘汰策略,按访问顺序保存最近使用的元素,自动淘汰最久未访问的元素。 - **按顺序存储并遍历**:`LinkedHashMap` 适合需要按插入顺序遍历元素的场景,比如记录日志信息、按插入顺序存储配置数据等。 - **需要有序性和高效查找的场景**:在需要兼顾数据有序和快速查找的情况下,`LinkedHashMap` 是一种高效的选择。 ### 4. `LinkedHashMap` 的性能分析 - **插入和删除**:由于基于 `HashMap` 实现,插入和删除操作的时间复杂度为 O(1)。 - **查找**:保持了 `HashMap` 的查找效率,平均时间复杂度为 O(1)。 - **遍历**:按照插入或访问顺序遍历,时间复杂度为 O(n)。 ### 5. `LinkedHashMap` 的代码示例 以下是一个使用 `LinkedHashMap` 的示例,展示按插入顺序遍历: ```java import java.util.LinkedHashMap; import java.util.Map; public class LinkedHashMapExample { public static void main(String[] args) { LinkedHashMap<String, Integer> map = new LinkedHashMap<>(16, 0.75f, true); map.put("A", 1); map.put("B", 2); map.put("C", 3); map.get("A"); // 访问 "A",若按访问顺序则 "A" 移动到末尾 // 按插入或访问顺序遍历 for (Map.Entry<String, Integer> entry : map.entrySet()) { System.out.println(entry.getKey() + " : " + entry.getValue()); } } } ``` ### 总结 `LinkedHashMap` 是基于 `HashMap` 和双向链表实现的,既有 `HashMap` 的高效查找特性,也能保证顺序遍历。通过 `before` 和 `after` 指针维护链表顺序,使得 `LinkedHashMap` 适用于需要按插入顺序或访问顺序遍历的场景。发布于 2024-11-09 19:57 •IP属地 天津举报评论收藏
公众号进入网站体验更佳
