
RedisCluster是怎么实现数据分片的?
1 个回答
 你爱你的玫瑰是因为你在你的玫瑰上花了太多的时间!吴敏首先Redis Cluster设定了有16384个槽位,然后根据启动时集群的主节点数量进行均分,每个主节点得到一定数量的槽位,为了保证每个主节点挂掉之后,服务保持高可用,一般会为每个主节点配置几个从节点,从节点保存了主节点上同步过来的数据,一旦主节点挂掉,会有一个从节点会被选为主节点。客户端在与Redis Cluster建立连接时会获取到各槽位与主节点之间的映射关系,然后缓存到本地。 客户端执行命令的流程: 假设客户端需要发送一个查询请求时,首先会对key使用CRC16算法计算得到一个hash值,然后将hash值与16384(也就是2的14次方)进行取模(下面是网上找的图,应该是CRC16(key)%16384),得到一个槽位slot,然后根据本地缓存的槽位映射关系表,找到这个槽位slot对应的主节点,发送查询命令。主节点在收到命令后会有以下几种情况: ### 1.这个主节点确实负责这个槽位,且不在迁移中。 直接查询到这个键值对,返回给客户端。 ### 2.这个主节点不负责这个槽位,或者已经确定转移到其他节点上去了(Moved指令) 可能是这个槽位已经迁移了,或者是客户端将指令发送到了错误的节点,或者是客户端缓存的槽位映射关系以前过期。主节点就会给客户端返回Moved指令及正确的节点信息,Moved指令相当于是一个永久重定向指令,用于纠正客户端缓存的错误槽位信息。客户端收到后会更新本地的槽位关系表,然后向正确的节点发送查询指令。 ### 3.这个槽位正在迁移中(ASKING指令) 如果这个槽位之前是在这个主节点上,但是目前正在迁移(槽位状态为IMPORTING),那么如果现在主节点上存在这个可以,就成功处理请求。否则就返回ASKING指令+槽位所在的新节点,ASKING指令相当于是一个临时重定向指令,客户端收到之后不会更新本地的槽位关系表,只是将本次请求发送到新节点。 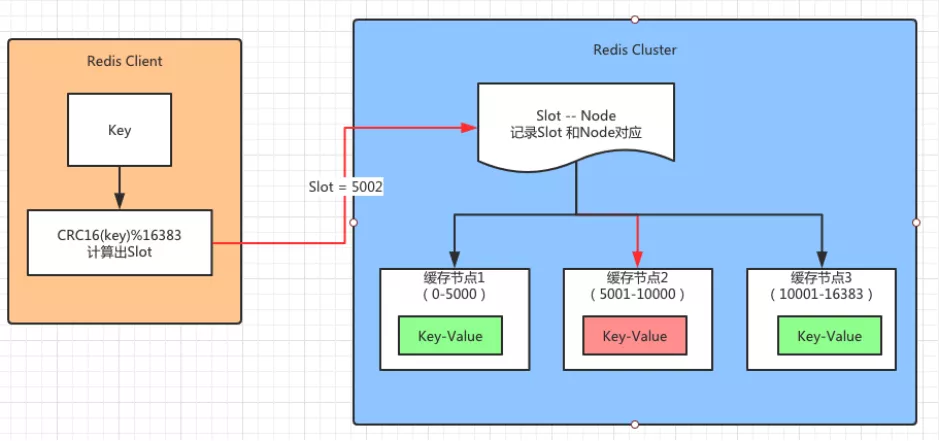 ### Redis Cluster的节点扩容和下线 #### 扩容 例如数据量太大了,原有的节点太少了,希望增加一些Redis实例,分担一些数据量。在Redis Cluster中,需要程序员手动执行命令,将节点添加到集群,并执行命令从其他的主节点上分配一些槽位到这个新节点上。 具体执行命令流程如下: ```java ./redis-trib.rb add-node 127.0.0.1:7006 127.0.0.1:7000 ``` 可以看到.使用addnode命令来添加节点,第一个参数是新节点的地址,第二个参数是任意一个已经存在的节点的IP和端口。 新节点现在已经连接上了集群, 成为集群的一份子, 并且可以对客户端的命令请求进行转向了, 但是和其他主节点相比, 新节点还有两点区别: 1. 新节点没有包含任何数据, 因为它没有包含任何哈希槽位. 2. 尽管新节点没有包含任何哈希槽位, 但它仍然是一个主节点, 所以在集群需要将某个从节点升级为新的主节点时, 这个新节点不会被选中。 接下来, 只要使用 redis-trib 程序, 将集群中的某些哈希槽位移动到新节点里面, 新节点就会成为真正的主节点了。 槽位迁移需要执行的命令会比较的多,大家想了解的可以看看这篇文章: [https://www.cnblogs.com/youngchaolin/archive/2004/01/13/12034660.html](https://www.cnblogs.com/youngchaolin/archive/2004/01/13/12034660.html) 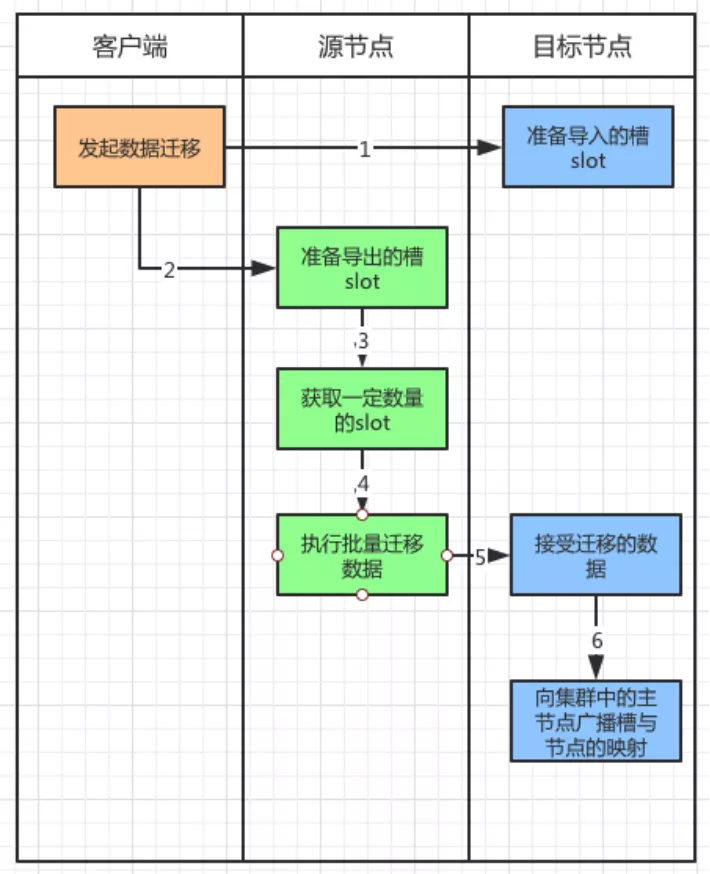 #### 下线 在节点上执行 redis-trib.rb del-node{host:port} {donwNodeId} 通知其他的节点,自己下线,如果本节点是主节点,会安排对应的从节点阶梯主节点的位置。编辑于 2022-02-14 15:55 •IP属地 江西举报评论收藏
公众号进入网站体验更佳
