
聊聊HashMap 的扩容方式?HashMap是如何扩容的?
2 个回答
 杯中之物从来不能消愁补过柯海#### 1. 什么时候才需要扩容 当 `HashMap` 中的元素个数超过当前数组的大小(数组长度)与负载因子(`loadFactor`)的乘积时,就会触发扩容操作。默认的 `loadFactor` 值为 `0.75`,因此当元素个数超过 `容量 * 0.75` 时,`HashMap` 会进行扩容。 #### 2. HashMap 的扩容是什么 扩容时,`HashMap` 会进行重新 `rehash`,即重新计算每个元素的位置,这个过程非常耗时。为了减少 `rehash` 的开销,`HashMap` 在扩容时采用了一个巧妙的策略:扩容是翻倍的,每次扩容时,数组的大小都会翻倍,并且新的 `hash` 计算只会根据新增的一个 bit 位来决定元素的位置。因此,元素要么留在原来的位置,要么被移动到新数组中的 "原位置 + 旧容量" 这个位置。 #### 扩容过程示意图 例如,当数组从 16 扩展为 32 时,扩容过程中的变化如下: 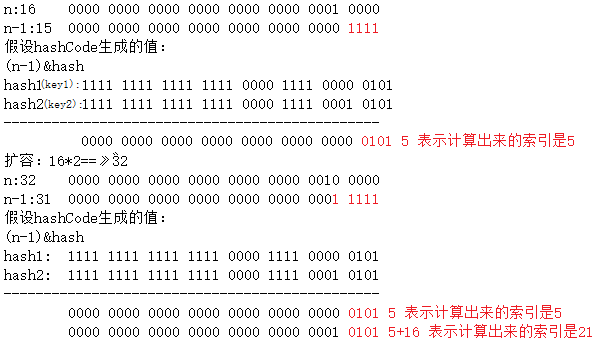 扩容后,`n`(数组长度)变成了原来的两倍,新计算的 `n-1` 范围(用于决定元素的位置)多了一个高位(红色部分)。因此,元素的位置会根据新增的 bit 位来调整。 #### 解释扩容后的位置变化 假设扩容前元素在索引 `5` 位置(如图所示),扩容后的新数组为 32 个槽位,新的索引会根据扩容后新增的 bit 位来重新计算。结果如下: 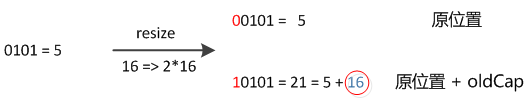 这验证了扩容后,元素要么留在原来的位置,要么移动到 "原位置 + 旧容量" 这个新位置。扩容时,通过判断 `hash & oldCap` 来决定元素是留在原位置,还是移动到新位置。 #### 3. HashMap 扩容的优势 这种扩容机制具有两个主要优势: - **性能优化**:扩容时无需重新计算 hash 值,只需要利用新的 bit 位判断元素是否需要移动。这样,避免了频繁的 hash 计算,提升了性能。 - **均匀分布**:由于新增的 bit 位为 0 或 1 是随机的,因此在扩容过程中,HashMap 能够保持良好的均匀性,避免出现严重的 hash 冲突,从而提升查询效率。 #### 4. 源码解读 在实际源码中,`resize` 方法实现了扩容操作,具体实现如下: ```java final Node<K,V>[] resize() { // 得到当前数组 Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int oldThr = threshold; int newCap, newThr = 0; // 计算扩容后的新容量 if (oldCap > 0) { if (oldCap >= MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return oldTab; } else if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY && oldCap >= DEFAULT_INITIAL_CAPACITY) { newThr = oldThr << 1; // double threshold } } else if (oldThr > 0) { newCap = oldThr; } else { newCap = DEFAULT_INITIAL_CAPACITY; // 默认容量 newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY); } // 计算新的阈值 if (newThr == 0) { float ft = (float)newCap * loadFactor; newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY ? (int)ft : Integer.MAX_VALUE); } threshold = newThr; Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; // 创建新的哈希表 table = newTab; // 重新计算并插入元素 if (oldTab != null) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) { newTab[e.hash & (newCap - 1)] = e; } else if (e instanceof TreeNode) { ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); } else { Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; Node<K,V> next; do { next = e.next; if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = next) != null); if (loTail != null) { loTail.next = null; newTab[j] = loHead; } if (hiTail != null) { hiTail.next = null; newTab[j + oldCap] = hiHead; } } } } } return newTab; } ``` ### 5. 总结 - **扩容时机**:当元素个数超过 `容量 * loadFactor` 时,触发扩容。 - **扩容方式**:扩容是翻倍的,利用新增的一个 bit 位来决定元素的位置。通过 `hash & oldCap` 判断元素是否需要移动到新位置。 - **性能优化**:扩容过程避免了重新计算 hash 值,且通过合理分布减少了 hash 冲突,保证了查询性能。 这种巧妙的扩容机制,使得 `HashMap` 在大规模数据存储和检索时保持高效的性能。发布于 2024-10-26 11:36 •IP属地 山西举报评论收藏
 好运不会眷顾傻瓜。陈飞`HashMap` 的扩容机制在 JDK 7 和 JDK 8 中有一定差异,但总体流程相似。扩容的基本原理是:当 `HashMap` 中的元素个数超过阈值(即 `capacity * loadFactor`)时,会触发扩容操作,将原来的数组扩容为原来容量的两倍,并重新计算每个元素在新数组中的位置。 ### `HashMap` 扩容的基本流程(以 JDK 8 为例): 1. **触发条件** - 当 `HashMap` 中存储的元素数量超过 `threshold`(通常是 `capacity * loadFactor`)时,会触发扩容操作。 - `HashMap` 的默认初始容量为 16,默认加载因子为 0.75,因此当元素数量超过 12 时(16 * 0.75),会触发扩容。 2. **扩容后的容量** - 扩容时,新数组的容量是旧数组容量的 2 倍。通过位移操作 `oldCap << 1` 来计算新容量,保证数组长度始终是 2 的幂次方。 3. **rehash(重计算索引)** - 在扩容时,所有元素需要重新计算其在新数组中的索引。JDK 8 的 `HashMap` 采用了一种非常巧妙的方式,不需要重新计算 `hash`,而是通过简单的位运算将元素重新分配到新数组。 - 新数组的长度是旧数组的两倍,这意味着 `hash & (newCap - 1)` 与 `hash & (oldCap - 1)` 的差别只在于新数组长度多了一个高位(`oldCap` 对应的那一位)。 - 如果 `hash & oldCap == 0`,说明元素的位置在扩容后没有改变。 - 如果 `hash & oldCap != 0`,说明元素需要被移到新数组中的索引 `oldIndex + oldCap`。 4. **扩容后的重新分配** - JDK 8 中通过位运算避免了重新计算 `hash` 值,只需要根据 `hash & oldCap` 来判断元素是否需要移动,既简化了操作,又提高了效率。 - 链表中的元素可能会被分配到新数组的不同位置,从而避免冲突,减少链表长度。 ### 扩容的核心代码解释: 1. **`resize()` 方法** - `resize()` 是 `HashMap` 扩容的核心方法,负责创建一个新数组并将旧数组中的元素移动到新数组中。 ```java final Node<K,V>[] resize() { Node<K,V>[] oldTab = table; int oldCap = (oldTab == null) ? 0 : oldTab.length; int newCap = oldCap << 1; // 新容量是原来的两倍 Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap]; // 新建一个容量为 newCap 的数组 table = newTab; // 使用新数组 transfer(oldTab, newTab, oldCap); // 将旧数组中的元素转移到新数组中 return newTab; } ``` 2. **`transfer()` 方法** - `transfer()` 方法负责将旧数组中的元素重新分配到新数组。 ```java void transfer(Node<K,V>[] oldTab, Node<K,V>[] newTab, int oldCap) { for (int j = 0; j < oldCap; ++j) { Node<K,V> e; if ((e = oldTab[j]) != null) { oldTab[j] = null; if (e.next == null) { newTab[e.hash & (newTab.length - 1)] = e; // 重新分配位置 } else if (e instanceof TreeNode) { ((TreeNode<K,V>)e).split(this, newTab, j, oldCap); // 红黑树处理 } else { // 链表优化 Node<K,V> loHead = null, loTail = null; Node<K,V> hiHead = null, hiTail = null; do { if ((e.hash & oldCap) == 0) { if (loTail == null) loHead = e; else loTail.next = e; loTail = e; } else { if (hiTail == null) hiHead = e; else hiTail.next = e; hiTail = e; } } while ((e = e.next) != null); newTab[j] = loHead; newTab[j + oldCap] = hiHead; } } } } ``` 3. **`hash & oldCap` 的作用** - `hash & oldCap == 0` 表示元素在扩容后的新数组中位置不变。 - `hash & oldCap != 0` 表示元素需要移动到新数组中索引 `j + oldCap` 位置。 ### JDK 7 和 JDK 8 的主要区别: - **JDK 7:** - 在扩容时,需要重新计算所有元素的 `hash` 值,然后通过 `hash % newCapacity` 来确定新位置。 - 扩容后,旧数组中的链表会按顺序重新放入新数组的不同位置。 - **JDK 8:** - JDK 8 的 `HashMap` 在扩容时,使用 `hash & oldCap` 来快速判断元素是否需要移动到新索引位置,而不是重新计算 `hash` 值,极大地提高了扩容效率。 - 另外,在处理冲突时,如果链表长度超过一定阈值,`HashMap` 会将链表转换为红黑树,进一步优化查询性能。 ### 总结: - **扩容条件**:当 `HashMap` 中的元素个数超过负载因子定义的容量时,触发扩容,扩容后的数组长度是原来的两倍。 - **rehash 原理**:JDK 8 中通过位运算 `hash & oldCap` 判断是否需要将元素移动到新索引位置,而不需要重新计算 `hash`,提高了扩容效率。 - **优化措施**:在 JDK 8 中,链表长度超过阈值时会转换为红黑树,以提高性能。发布于 2024-09-03 07:30 •IP属地 内蒙古举报评论收藏
公众号进入网站体验更佳
