
谈一谈你对跳跃表的理解?
2 个回答
 明知不可为而为之就是我最大的诚意加刑天跳跃表(**Skip List**)是一种有序的数据结构,它通过维护多层索引来加速对元素的查找、插入和删除操作。可以理解为一种链表的升级版,它能够提供接近于**二分查找**的效率,同时保持了链表的灵活性。跳跃表被广泛用于实现 Redis 中的有序集合(`zset`)。 ### 1. **跳跃表的基本概念** 跳跃表可以看作是**多个层次的有序链表**叠加在一起。最底层是一个普通的**有序链表**,然后在其上面创建多级“跳跃层”作为索引,用来跳过一些节点,以加快查找速度。 - **层次结构**:跳跃表由多个链表层次构成,最底层的链表包含了所有元素,每一层都是有序的。上层的链表是下层链表的索引,用于“跳过”部分元素,从而加速操作。 - **每个元素可能出现在不同的层次上**:在跳跃表中,每个节点会随机地被提升到更高的层次,形成了类似塔状结构。提升的层数取决于随机选择的概率(通常是 1/2 的概率提升一层),因此越高的层次节点越少,底层节点越多。 ### 2. **跳跃表的查找过程** 跳跃表的查找过程类似于在多个链表之间进行跳跃式的查找,因此其名字叫“跳跃表”。 查找某个元素时,过程如下: 1. **从最高层开始**:首先从最高层的链表开始搜索,寻找比目标元素小且离它最近的元素。 2. **向右查找**:在当前层次的链表中,顺着链表向右查找。如果发现目标元素比当前节点大,则继续向右查找。 3. **向下移动**:当无法继续向右查找时(即目标元素比当前节点大,但比下一个节点小),就跳到下一层链表继续搜索。 4. **重复以上步骤**:重复上述过程,直到找到目标元素或到达最底层的链表。 由于每次从较高层次开始跳跃搜索,跳跃表的查找复杂度约为 **O(log n)**,其中 `n` 是跳跃表中元素的个数。 ### 3. **跳跃表的插入和删除操作** - **插入操作**: - 插入元素时,首先要按照查找的过程确定该元素应该插入的位置。 - 然后,通过随机数决定该元素的层数。在每一层对应的位置插入新节点。越高层的索引链表插入的节点越少,底层链表总是插入所有元素。 - 插入操作的时间复杂度也是 **O(log n)**。 - **删除操作**: - 删除操作和插入类似,首先要找到要删除的节点,然后逐层将节点从跳跃表的不同层次链表中移除。删除操作的时间复杂度也是 **O(log n)**。 ### 4. **跳跃表与平衡树的对比** 跳跃表的性能与平衡树(如 AVL 树、红黑树)相近,都是 **O(log n)** 复杂度的查找、插入和删除。但是,跳跃表和平衡树在实现上的差异在于: - **跳跃表的实现相对简单**:跳跃表通过多层链表和随机化的方式实现,不需要像平衡树那样复杂的旋转和重平衡操作。相比之下,平衡树的实现更加复杂,维护树的平衡需要额外的操作。 - **空间消耗**:跳跃表通过随机化的索引来提高查找速度,这需要额外的空间来存储不同层次的链表。通常情况下,跳跃表的空间复杂度是 **O(n)**。 - **随机化操作**:跳跃表依赖于随机化来决定元素应该出现在多少层上,这使得跳跃表的插入操作具有概率性,最终的层次结构是不确定的。而平衡树总是保证其结构在逻辑上是完全平衡的。 ### 5. **跳跃表的特点** - **效率**:跳跃表的查找、插入和删除操作的平均时间复杂度都是 **O(log n)**,与平衡树相当,但实现更加简单。 - **灵活性**:跳跃表比树结构更加灵活,链表可以动态扩展,而树结构则更加固定。 - **简单性**:跳跃表的实现比平衡树要简单得多,特别是在多线程环境下,不需要复杂的平衡操作,插入和删除都很容易实现。 - **随机化**:跳跃表通过随机化提升层数来构建索引,这使得跳跃表的效率接近于二分查找或平衡树。 ### 6. **Redis 中的跳跃表** 在 Redis 中,跳跃表被用于实现 **有序集合(zset)**。有序集合允许根据元素的分数进行排序,支持高效的范围查找、插入和删除操作。Redis 之所以选择跳跃表,是因为它可以高效地处理有序数据,且实现相对简单。 有序集合的底层数据结构是 **跳跃表 + 哈希表** 的组合: - 跳跃表用于实现元素按分数排序的功能,可以高效进行范围查询。 - 哈希表用于快速根据元素名查找元素的分数,实现 **O(1)** 的查找。 这种组合结构既保证了有序性,又保证了高效查找,是 Redis 中有序集合性能的保证。 ### 7. **跳跃表的时间复杂度** - **查找**:O(log n) - **插入**:O(log n) - **删除**:O(log n) - **空间复杂度**:O(n) 跳跃表通过多层链表和随机化提升机制来加速查找和更新操作,查找和更新的时间复杂度接近于 **O(log n)**,类似于平衡树。 ### 总结: 跳跃表是一种通过在有序链表的基础上引入多层索引结构的高效数据结构,它通过随机化索引层级来加快查找、插入和删除操作。相比于平衡树,跳跃表的实现更为简单,且能够提供相似的时间复杂度。跳跃表在 Redis 中用于实现有序集合,帮助 Redis 高效地处理有序数据的存储和查找。发布于 2022-04-30 14:59 •IP属地 青海举报评论收藏
 鸟随鸾凤飞腾远,人伴贤良品自高。无邪就是单链表的查找的时间复杂度为O(N),为了提高查询效率,可增加一些索引节点,让查询时间复杂度降低为O(logN)。(只有底层单链表会保存节点数据,上层的节点之后保存几个索引项和分数,也就是向左指向前一个节点的索引,向右指向后一个节点的索引,向下指向上一级的索引。) 时间复杂度的推理过程可以认为,从每一级索引中两个节点中选一个节点作为下一级索引的节点,让下一级索引的节点数量为本级索引节点数量的一半。假设原始链表的长度为n,第一级索引节点个数为n/2,第二级为n/4,一直到最高层。 ```java 假设h为层数,f(h)为该层索引节点数量。 f(h)=n/(2^h) 而最高层的索引节点会是只有两个索引节点。 也就是f(maxH)=n/(2^maxH)=2,所以最大层数maxH= log(n) - 1层 ,加上单链表的层数,总层数也就是log(n)层。 例如我们的单链表是1-19的,建立的多层索引如下, 如果我们要查找19,一开始在第四层遍历1,发现19>1,向右走,发现19>9,那么需要到上一级索引去找,然后发现19>13,继续到下一层,一直到第一层,发现19>17,然后往右走遍历17,18,19 所以每一层遍历的节点其实是 1 9 9 13 13 15 17 17 18 19 所以每一层最多遍历的节点数是<=3,这是由于每一层索引节点数是上一层的节点数的一半来得到的,每两个节点的区间,在上一层中都是两个区间,就是第三层的 1 5区间对应上一层的1 3 区间和3 5 区间。 所以时间复杂度=总层数*每层遍历节点数=3logN,去掉常数后是log(N) 第四层 1 9 第三层 1 5 9 13 第二层 1 3 5 7 9 11 13 15 17 第一层 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 ``` 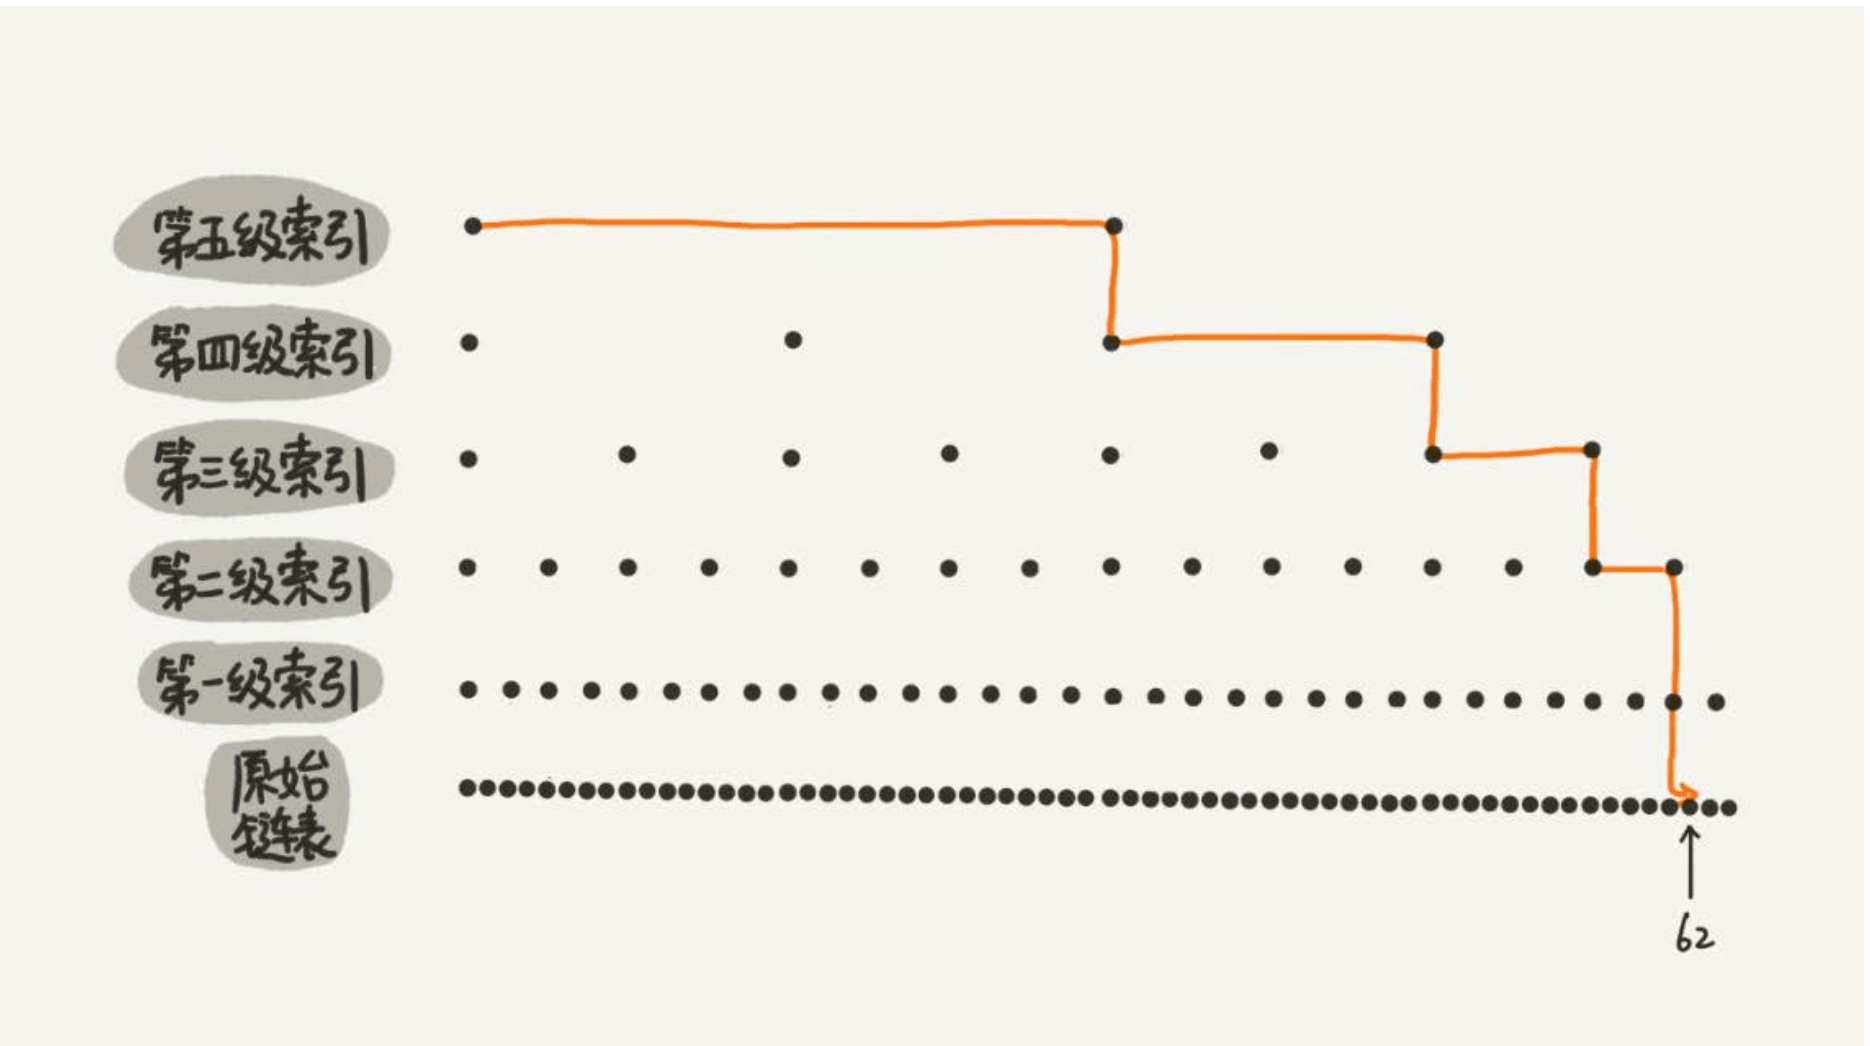 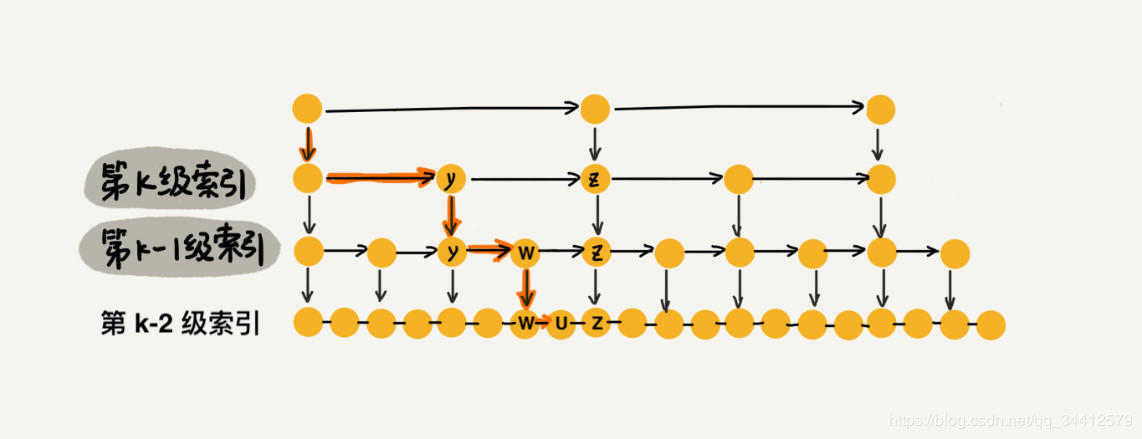 但是这种全索引的结构有缺点,就是之后在插入新节点时,是没有办法为新节点添加一些新的索引节点的。所以有可能会导致一个小区间内有很多个节点,查找时近似于单链表,这样时间复杂度就变成O(N)了,所以Redis对跳跃表做了一些优化,可以简单认为会计算出一个随机数,代表这个添加添加的索引层数,然后进行添加。同时假设节点拥有k层索引的概率f(k),节点拥有k-1层索引结构的概率为f(k-1),f(k) = f(k-1)P,假设p为1/2,那么也就是f(k)=f(k-1)\0.5,那么第k层的索引节点数也就是为k-1层的0.5倍。最终索引结构跟上面的这种全索引结构是类似的,只是索引节点不一定分布均匀。空间复杂度=每一层索引节点数=n+n/2+n/4….=2n。Redis做了优化,发现P取1/4时,时间复杂度跟P取1/2是一样的,并且空间复杂度更低。 ```java //ZSKIPLIST_P代表获取下一层的概率,是0.25 //ZSKIPLIST_MAXLEVEL代表是最大层数,是32层 int zslRandomLevel(void) { int level = 1; while ((random()&0xFFFF) < (ZSKIPLIST_P * 0xFFFF)) level += 1; return (level<ZSKIPLIST_MAXLEVEL) ? level : ZSKIPLIST_MAXLEVEL; } ``` Redis计算总层数的算法大致是,初始层数是1层,在while循环内,取一个随机数, 有1/4的概率,层数+1。 有3/4的概率,层数不变,结束循环。 要原因是因为作为一种动态的数据结构,其删除和添加的节点是不可预测的,而跳跃表又不能像平衡二叉树那样,可以通过染色或者旋转来维持平衡,如果严格按照两个节点之间建立一个索引,在删除和添加节点时,需要更新的索引太多了。所以在这种情况下,就需要一种概率随机化的方式来自动均衡跳跃表的多级索引,通过这种方式虽然不能完全保证跳跃表的均匀性,但总体上可以使得跳跃表趋于平衡,从而能够达到较高的综合性能。 新插入了很多节点后带来的问题: 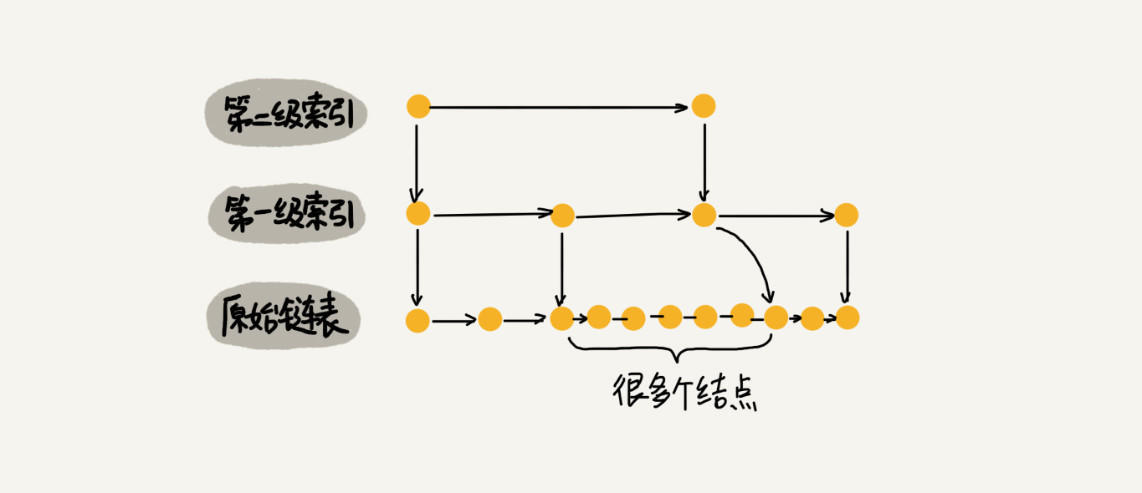 时间复杂度与空间复杂度 空间复杂度的公式是 空间复杂度= 1/(1-P) 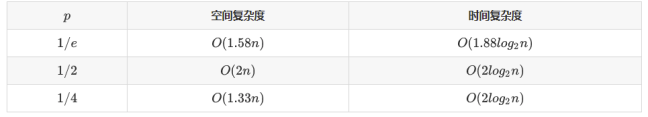发布于 2022-02-11 15:18 •IP属地 辽宁举报评论收藏
公众号进入网站体验更佳
