
HashMap put方法详解
put方法是比较复杂的,实现步骤大致如下:
1. 1.先通过 hash 值计算出 key 映射到哪个桶;
2. 2.如果桶上没有碰撞冲突,则直接插入;
3. 3.如果出现碰撞冲突了,则需要处理冲突:
a. 如果该桶使用红黑树处理冲突,则调用红黑树的方法插入数据;
b. 否则采用传统的链式方法插入。如果链的长度达到临界值,则把链转变为红黑树;
4. 4.如果桶中存在重复的键,则为该键替换新值 value;
5. 5.如果 size 大于阈值 threshold,则进行扩容;
具体的方法如下:
```java
public V put(K key, V value) {
return putVal(hash(key), key, value, false, true);
}
```
说明:
HashMap 只提供了 put 用于添加元素,putVal 方法只是给 put 方法调用的一个方法,并没有提供给用户使用。 所以我们重点看 putVal 方法。
我们可以看到在 putVal 方法中 key 在这里执行了一下 hash 方法,来看一下 hash 方法是如何实现的。
从上面可以得知 HashMap 是支持 key 为空的,而 HashTable 是直接用 Key 来获取hashCode 所以 key 为空会抛异常。
**解读上述 hash 方法:**
我们先研究下 key 的哈希值是如何计算出来的。key 的哈希值是通过上述方法计算出来的。
这个哈希方法首先计算出 key 的 hashCode 赋值给 h,然后与 h 无符号右移 16 位后的二进制进行按位异或得到最后的 hash 值。计算过程如下所示:
```java
static final int hash(Object key) {
int h;
return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
```
在 putVal 函数中使用到了上述 hash 函数计算的哈希值:
```java
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
...
if ((p = tab[i = (n - 1) & hash]) == null) // 这里的n表示数组长度16
...
}
```
计算过程如下所示:
说明:
```key.hashCode();返回散列值也就是 hashcode,假设随便生成的一个值。
n 表示数组初始化的长度是 16。
&(按位与运算):运算规则:相同的二进制数位上,都是 1 的时候,结果为 1,否则为0。
^(按位异或运算):运算规则:相同的二进制数位上,数字相同,结果为 0,不同为 1。
```
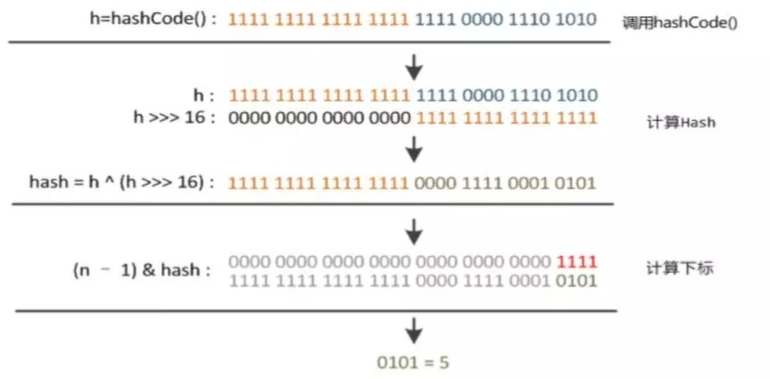
简单来说就是:
高 16bit 不变,低 16bit 和高 16bit 做了一个异或(得到的 hashCode 转化为 32 位二进制,前 16 位和后 16 位低 16bit 和高 16bit 做了一个异或)。
问题:为什么要这样操作呢?
如果当 n 即数组长度很小,假设是 16 的话,那么 n - 1 即为 1111 ,这样的值和 hashCode 直接做按位与操作,实际上只使用了哈希值的后 4 位。如果当哈希值的高位变化很大,低位变化很小,这样就很容易造成哈希冲突了,所以这里把高低位都利用起来,从而解决了这个问题。
现在看 putVal 方法,看看它到底做了什么。
主要参数:
1. hash:key 的 hash 值
2. key:原始 key
3. value:要存放的值
4. onlyIfAbsent:如果 true 代表不更改现有的值
5. evict:如果为false表示 table 为创建状态
putVal 方法源代码如下所示:
```java
public V put(K key, V value) {
return putVal(hash(key), key, value, false, true);
}
final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) {
Node<K,V>[] tab; Node<K,V> p; int n, i;
/*
1)transient Node<K,V>[] table; 表示存储Map集合中元素的数组。
2)(tab = table) == null 表示将空的table赋值给tab,然后判断tab是否等于null,第一次肯定是null。
3)(n = tab.length) == 0 表示将数组的长度0赋值给n,然后判断n是否等于0,n等于0,由于if判断使用双或,满足一个即可,则执行代码 n = (tab = resize()).length; 进行数组初始化,并将初始化好的数组长度赋值给n。
4)执行完n = (tab = resize()).length,数组tab每个空间都是null。
*/
if ((tab = table) == null || (n = tab.length) == 0)
n = (tab = resize()).length;
/*
1)i = (n - 1) & hash 表示计算数组的索引赋值给i,即确定元素存放在哪个桶中。
2)p = tab[i = (n - 1) & hash]表示获取计算出的位置的数据赋值给结点p。
3) (p = tab[i = (n - 1) & hash]) == null 判断结点位置是否等于null,如果为null,则执行代码:tab[i] = newNode(hash, key, value, null);根据键值对创建新的结点放入该位置的桶中。
小结:如果当前桶没有哈希碰撞冲突,则直接把键值对插入空间位置。
*/
if ((p = tab[i = (n - 1) & hash]) == null)
// 创建一个新的结点存入到桶中
tab[i] = newNode(hash, key, value, null);
else {
// 执行else说明tab[i]不等于null,表示这个位置已经有值了
Node<K,V> e; K k;
/*
比较桶中第一个元素(数组中的结点)的hash值和key是否相等
1)p.hash == hash :p.hash表示原来存在数据的hash值 hash表示后添加数据的hash值 比较两个hash值是否相等。
说明:p表示tab[i],即 newNode(hash, key, value, null)方法返回的Node对象。
Node<K,V> newNode(int hash, K key, V value, Node<K,V> next) {
return new Node<>(hash, key, value, next);
}
而在Node类中具有成员变量hash用来记录着之前数据的hash值的。
2)(k = p.key) == key :p.key获取原来数据的key赋值给k key 表示后添加数据的key比较两个key的地址值是否相等。
3)key != null && key.equals(k):能够执行到这里说明两个key的地址值不相等,那么先判断后添加的key是否等于null,如果不等于null再调用equals方法判断两个key的内容是否相等。
*/
if (p.hash == hash &&
((k = p.key) == key || (key != null && key.equals(k))))
/*
说明:两个元素哈希值相等,并且key的值也相等,将旧的元素整体对象赋值给e,用e来记录
*/
e = p;
// hash值不相等或者key不相等;判断p是否为红黑树结点
else if (p instanceof TreeNode)
// 放入树中
e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
// 说明是链表结点
else {
/*
1)如果是链表的话需要遍历到最后结点然后插入
2)采用循环遍历的方式,判断链表中是否有重复的key
*/
for (int binCount = 0; ; ++binCount) {
/*
1)e = p.next 获取p的下一个元素赋值给e。
2)(e = p.next) == null 判断p.next是否等于null,等于null,说明p没有下一个元素,那么此时到达了链表的尾部,还没有找到重复的key,则说明HashMap没有包含该键,将该键值对插入链表中。
*/
if ((e = p.next) == null) {
/*
1)创建一个新的结点插入到尾部
p.next = newNode(hash, key, value, null);
Node<K,V> newNode(int hash, K key, V value, Node<K,V> next) {
return new Node<>(hash, key, value, next);
}
注意第四个参数next是null,因为当前元素插入到链表末尾了,那么下一个结点肯定是null。
2)这种添加方式也满足链表数据结构的特点,每次向后添加新的元素。
*/
p.next = newNode(hash, key, value, null);
/*
1)结点添加完成之后判断此时结点个数是否大于TREEIFY_THRESHOLD临界值8,如果大于则将链表转换为红黑树。
2)int binCount = 0 :表示for循环的初始化值。从0开始计数。记录着遍历结点的个数。值是0表示第一个结点,1表示第二个结点。。。。7表示第八个结点,加上数组中的的一个元素,元素个数是9。
TREEIFY_THRESHOLD - 1 --》8 - 1 ---》7
如果binCount的值是7(加上数组中的的一个元素,元素个数是9)
TREEIFY_THRESHOLD - 1也是7,此时转换红黑树。
*/
if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st
// 转换为红黑树
treeifyBin(tab, hash);
// 跳出循环
break;
}
/*
执行到这里说明e = p.next 不是null,不是最后一个元素。继续判断链表中结点的key值与插入的元素的key值是否相等。
*/
if (e.hash == hash &&
((k = e.key) == key || (key != null && key.equals(k))))
// 相等,跳出循环
/*
要添加的元素和链表中的存在的元素的key相等了,则跳出for循环。不用再继续比较了
直接执行下面的if语句去替换去 if (e != null)
*/
break;
/*
说明新添加的元素和当前结点不相等,继续查找下一个结点。
用于遍历桶中的链表,与前面的e = p.next组合,可以遍历链表
*/
p = e;
}
}
/*
表示在桶中找到key值、hash值与插入元素相等的结点
也就是说通过上面的操作找到了重复的键,所以这里就是把该键的值变为新的值,并返回旧值
这里完成了put方法的修改功能
*/
if (e != null) {
// 记录e的value
V oldValue = e.value;
// onlyIfAbsent为false或者旧值为null
if (!onlyIfAbsent || oldValue == null)
// 用新值替换旧值
// e.value 表示旧值 value表示新值
e.value = value;
// 访问后回调
afterNodeAccess(e);
// 返回旧值
return oldValue;
}
}
// 修改记录次数
++modCount;
// 判断实际大小是否大于threshold阈值,如果超过则扩容
if (++size > threshold)
resize();
// 插入后回调
afterNodeInsertion(evict);
return null;
}
```
公众号进入网站体验更佳
