
HashMap集合详解专题-03HashMap面试题
#### 1.HashMap 中 hash 函数是怎么实现的?还有哪些hash函数的实现方式?
答:对于 key 的 hashCode 做 hash 操作,无符号右移 16 位然后做异或运算。还有平方取中法,伪随机数法和取余数法。这三种效率都比较低。而无符号右移 16 位异或运算效率是最高的。
#### 2.当两个对象的 hashCode 相等时会怎么样?
答:会产生哈希碰撞。若 key 值内容相同则替换旧的 value,不然连接到链表后面,链表长度超过阈值 8 就转换为红黑树存储。
#### 3.什么是哈希碰撞,如何解决哈希碰撞?
答:只要两个元素的 key 计算的哈希码值相同就会发生哈希碰撞。jdk8 之前使用链表解决哈希碰撞。jdk8之后使用链表 + 红黑树解决哈希碰撞。
#### 4.如果两个键的 hashCode 相同,如何存储键值对?
答:通过 equals 比较内容是否相同。相同:则新的 value 覆盖之前的 value。不相同:则将新的键值对添加到哈希表中。
#### 5.扩容为什么必须是 2 的 n 次幂?如果输入值不是 2 的幂比如 10 会怎么样?
HashMap 构造方法还可以指定集合的初始化容量大小:
```java
// 构造一个带指定初始容量和默认负载因子(0.75)的空 HashMap。
HashMap(int initialCapacity)
```
根据上述讲解我们已经知道,当向 HashMap 中添加一个元素的时候,需要根据 key 的 hash 值,去确定其在数组中的具体位置。HashMap 为了存取高效,减少碰撞,就是要尽量把数据分配均匀,每个链表长度大致相同,这个实现的关键就在把数据存到哪个链表中的算法。
这个算法实际就是取模,hash % length,计算机中直接求余效率不如位移运算。所以源码中做了优化,使用 hash & (length - 1),而实际上 hash % length 等于 hash & ( length - 1) 的前提是 length 是 2 的 n 次幂。
例如长度为 8 的时候,3 & (8 - 1) = 3,2 & (8 - 1) = 2,不同位置上,不碰撞。
```java
/**
* Returns a power of two size for the given target capacity.
*/
static final int tableSizeFor(int cap) {
int n = cap - 1;
n |= n >>> 1;
n |= n >>> 2;
n |= n >>> 4;
n |= n >>> 8;
n |= n >>> 16;
return (n < 0) ? 1 : (n >= MAXIMUM_CAPACITY) ? MAXIMUM_CAPACITY : n + 1;
}
```
说明:
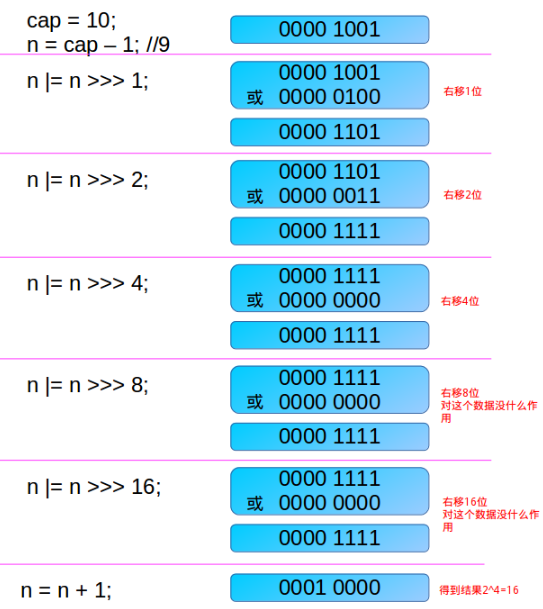
当在实例化 HashMap 实例时,如果给定了 initialCapacity,由于 HashMap 的 capacity 必须都是 2 的幂,因此这个方法用于找到大于等于 initialCapacity 的最小的 2 的幂。
分析:
int n = cap - 1;
防止 cap 已经是 2 的幂。如果 cap 已经是 2 的幂,又没有这个减 1 操作,则执行完后面的几条无符号操作之后,返回的 capacity 将是这个 cap 的 2 倍。
如果 n 这时为 0 了(经过了cap - 1后),则经过后面的几次无符号右移依然是 0,最后返回的 capacity 是1(最后有个 n + 1 的操作)。
注意:容量最大也就是 32bit 的正数,因此最后 n |= n >>> 16; 最多也就 32 个 1(但是这已经是负数了,在执行 tableSizeFor 之前,对 initialCapacity 做了判断,如果大于MAXIMUM_CAPACITY(2 ^ 30),则取 MAXIMUM_CAPACITY。如果等于MAXIMUM_CAPACITY,会执行位移操作。所以这里面的位移操作之后,最大 30 个 1,不会大于等于 MAXIMUM_CAPACITY。30 个 1,加 1 后得 2 ^ 30)。
注意:得到的这个 capacity 却被赋值给了 threshold。
```java
this.threshold = tableSizeFor(initialCapacity);
```
公众号进入网站体验更佳
