
从根上理解SQL的like查询%在前为什么不走索引?
昨天就有人问我,like 查询 % 在前为什么不走索引?不能人云亦云,我们应该从根上理解它,为什么要这样设计?为什么不走索引?
其实结果对我来说,并不重要,重要的是过程。设计过程或者实现过程,这才是我最关心的。所以,今天我就从根上给你说一说为什么 like 查询 % 在前为什么不走索引?
例如,看这个例子:

说到这个例子,估计很多人会提到最左匹配原则。那么为什么要搞一个最左匹配原则呢?为什么不搞一个最右匹配原则?
这个问题,其实是和 B+Tree 有些关系,索引树从左到右都是有顺序的。对于索引中的关键字进行对比的时候,一定是从左往右以此对比,且不可跳过。
为什么是最左匹配原则?这个其实很好理解。比如,我们要比较一个字符串。xttblog 与 xmtblog,我们肯定是先从第一个字符开始比较吧,第一个相同后,再比较第二个字符,以此类推。所以要从左边开始,并且是不能跳过的。SQL 索引也是这样的。
然后,我们再来看标题中的问题。% 在前,就代表,我前面的内容不确定。不确定,我们怎么比较?只能一个一个的比较,那就相当于,全匹配了,全匹配就不需要索引,还不如直接全表扫描。
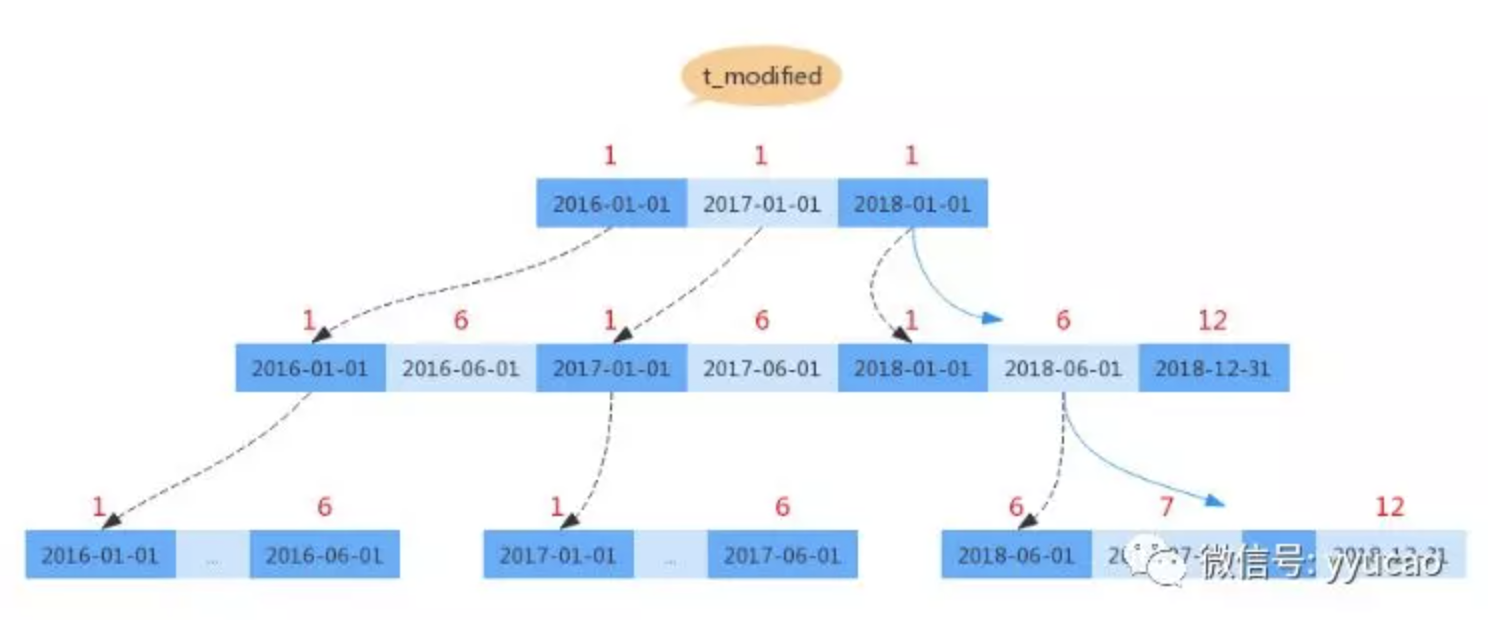
在关键字比较的时候,会把字符串转换成 ascll 码,如 abc 变成 97 98 99,然后从左往右一个字符一个字符进行对比。like %xttblog 这个怪物,因为 % 表示全匹配,所以 MySQL 就放弃索引了,进行全表扫描。
公众号进入网站体验更佳
