
HashMap集合详解专题-02HashMap 集合底层的数据结构
1.存储数据的过程
示例代码:
```java
HashMap<String, Integer> map = new HashMap<>();
map.put("柳岩", 18);
map.put("杨幂", 28);
map.put("刘德华", 40);
map.put("柳岩", 20);
```
输出结果:
```java
{杨幂=28, 柳岩=20, 刘德华=40}
```
分析:
1. 1.当创建 HashMap 集合对象的时候,HashMap 的构造方法并没有创建数组,而是在第一次调用 put 方法时创建一个长度是16 的数组 Node[] table (jdk1.8 之前是 Entry[] table)用来存储键值对数据。
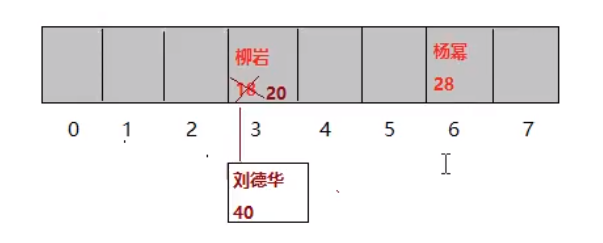
2. 2.假设向哈希表中存储 <柳岩,18> 数据,根据柳岩调用 String 类中重写之后的 hashCode() 方法计算出值,然后结合数组长度采用某种算法计算出向 Node 数组中存储数据的空间的索引值。如果计算出的索引空间没有数据,则直接将<柳岩,18>存储到数组中。(举例:计算出的索引是 3 )
3. 3.向哈希表中存储数据 <刘德华,40>,假设算出的 hashCode() 方法结合数祖长度计算出的索引值也是3,那么此时数组空间不是 null,此时底层会比较柳岩和刘德华的 hash 值是否一致,如果不一致,则在空间上划出一个结点来存储键值对数据对 <刘德华,40>,这种方式称为拉链法。
4. 4.假设向哈希表中存储数据 <柳岩,20>,那么首先根据柳岩调用 hashCode() 方法结合数组长度计算出索引肯定是 3,此时比较后存储的数据柳岩和已经存在的数据的 hash 值是否相等,如果 hash 值相等,此时发生哈希碰撞。那么底层会调用柳岩所属类 String 中的 equals() 方法比较两个内容是否相等:
相等:将后添加的数据的 value 覆盖之前的 value。
不相等:继续向下和其他的数据的 key 进行比较,如果都不相等,则划出一个结点存储数据,如果结点长度即链表长度大于
阈值 8 并且数组长度大于 64 则将链表变为红黑树。
5. 5.在不断的添加数据的过程中,会涉及到扩容问题,当超出阈值(且要存放的位置非空)时,扩容。默认的扩容方式:扩容为原来容量的 2 倍,并将原有的数据复制过来。
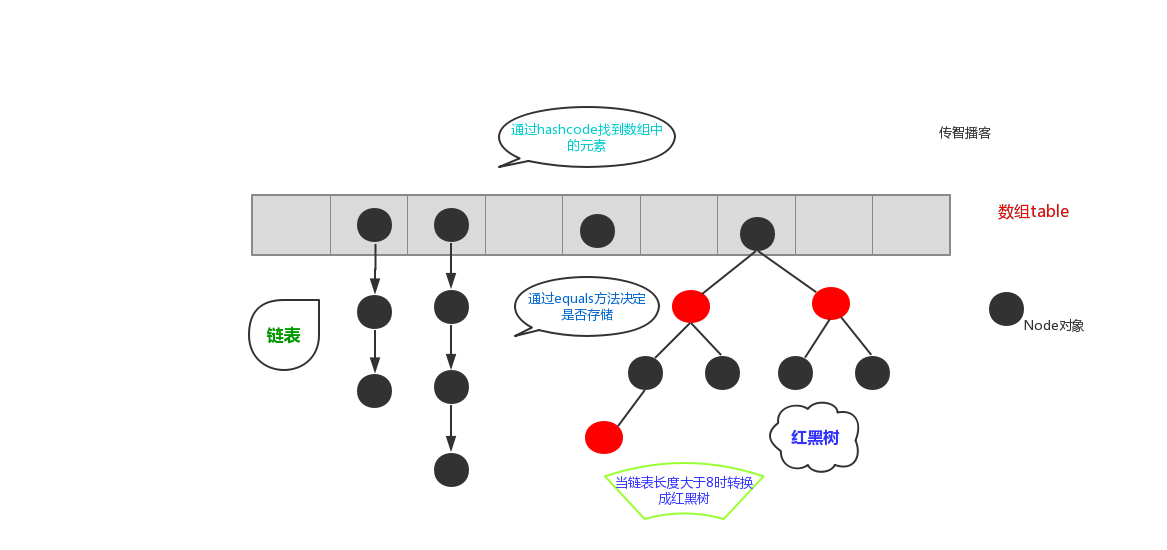
6. 6.综上描述,当位于一个表中的元素较多,即 hash 值相等但是内容不相等的元素较多时,通过 key 值依次查找的效率较低。而 jdk1.8 中,哈希表存储采用数组+链表+红黑树实现,当链表长度(阈值)超过8且当前数组的长度大于64时,将链表转换为红黑树,这样大大减少了查找时间。
简单的来说,哈希表是由数组+链表+红黑树(JDK1.8增加了红黑树部分)实现的。如下图所示:
7. 7.jdk1.8 中引入红黑树的进一步原因:
8. jdk1.8 以前 HashMap 的实现是数组+链表,即使哈希函数取得再好,也很难达到元素百分百均匀分布。当 HashMap 中有大量的元素都存放到同一个桶中时,这个桶下有一条长长的链表,这个时候 HashMap 就相当于一个单链表,假如单链表有n个元素,遍历的时间复杂度就是O(n),完全失去了它的优势。
8. 针对这种情况,jdk1.8 中引入了红黑树(查找时间复杂度为 O(logn))来优化这个问题。当链表长度很小的时候,即使遍历,速度也非常快,但是当链表长度不断变长,肯定会对查询性能有一定的影响,所以才需要转成树。
9. 8.总结:
10. 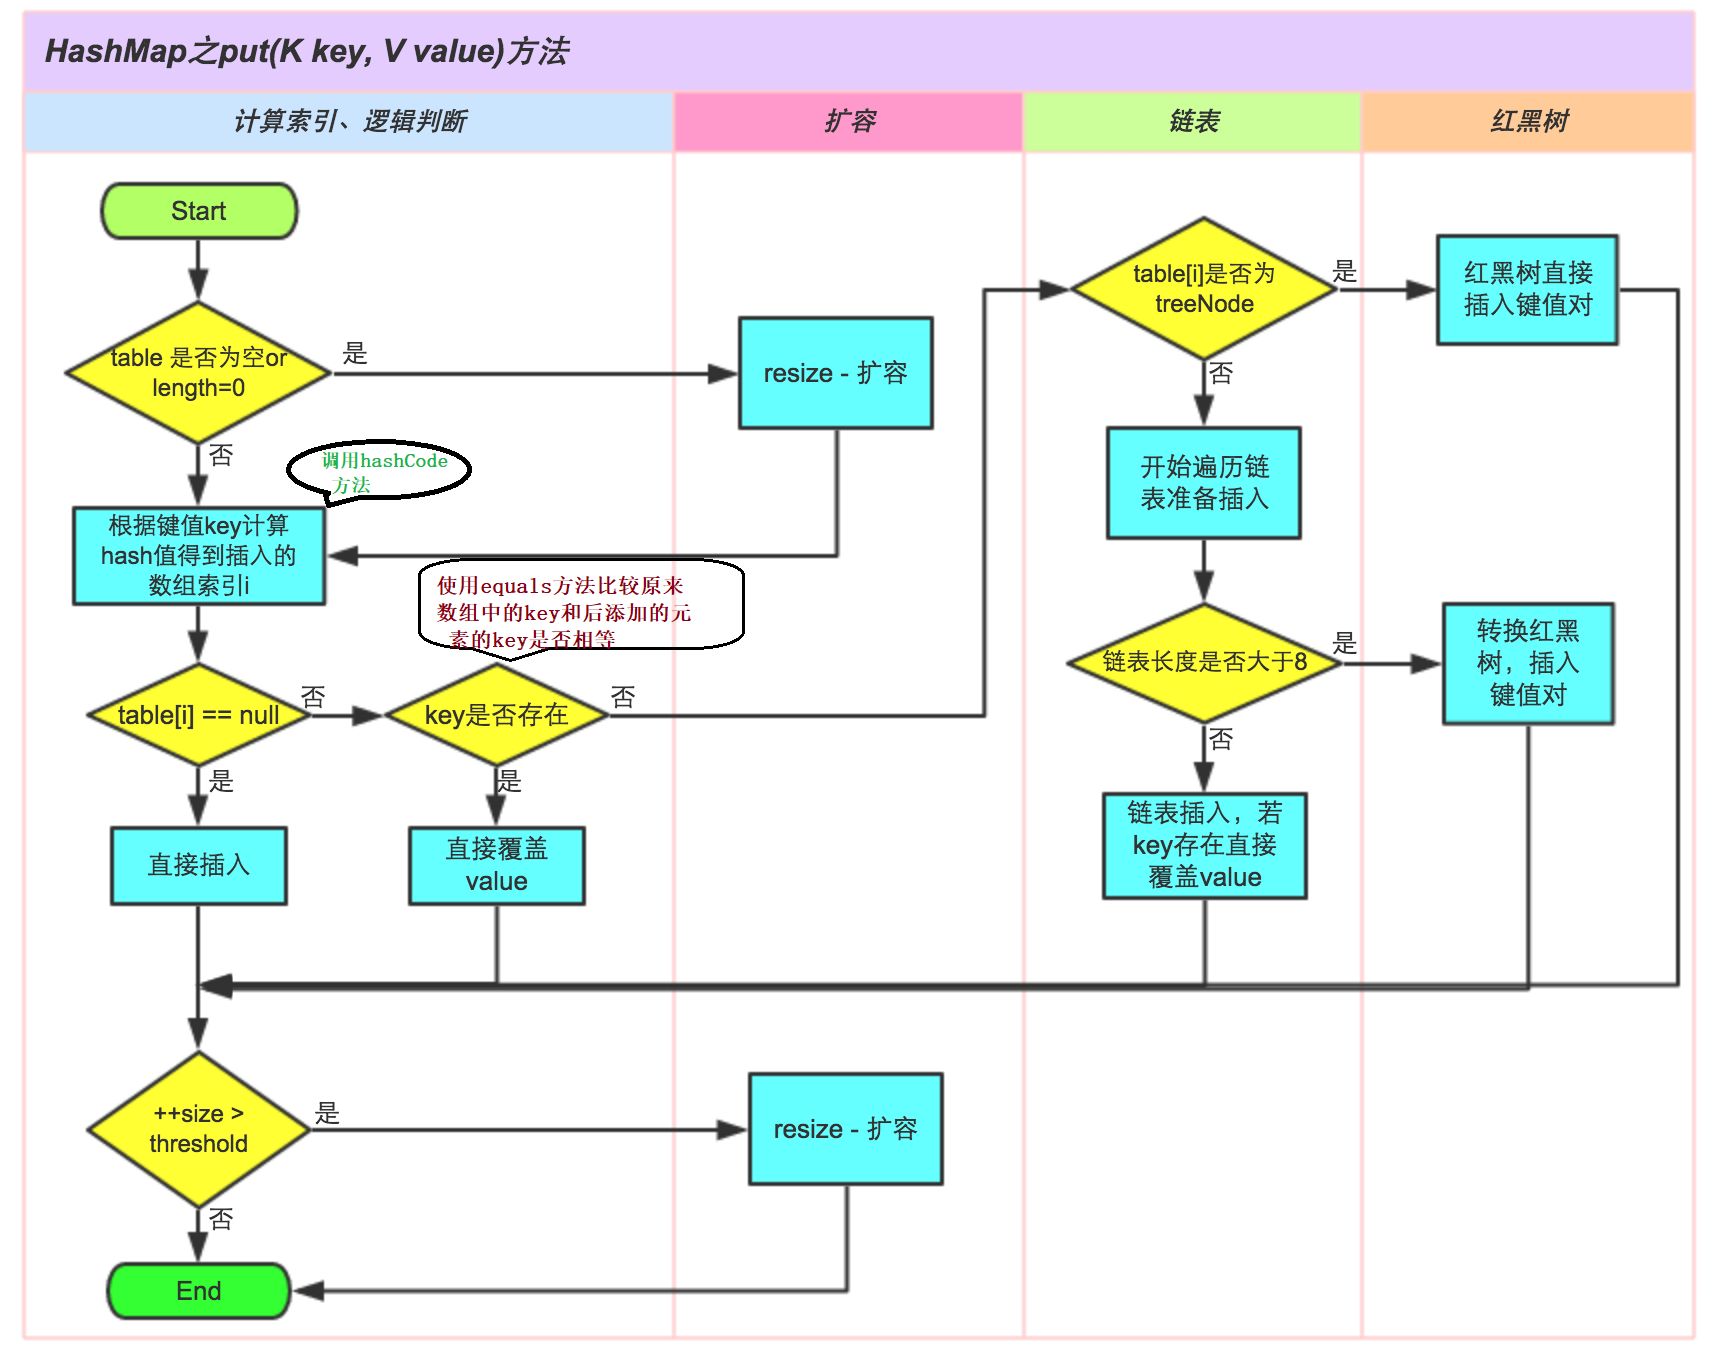
10. 9.说明:
11. size 表示 HashMap 中键值对的实时数量,注意这个不等于数组的长度。
threshold(临界值)= capacity(容量)* loadFactor(负载因子)。这个值是当前已占用数组长度的最大值。size 超过这个值就重新 resize(扩容),扩容后的 HashMap 容量是之前容量的两倍。
公众号进入网站体验更佳
